Scrapling:82K Star的Python自适应爬虫框架,自愈选择器让爬虫永不过时
目录
Scrapling:82K Star的Python自适应爬虫框架,自愈选择器让爬虫永不过时
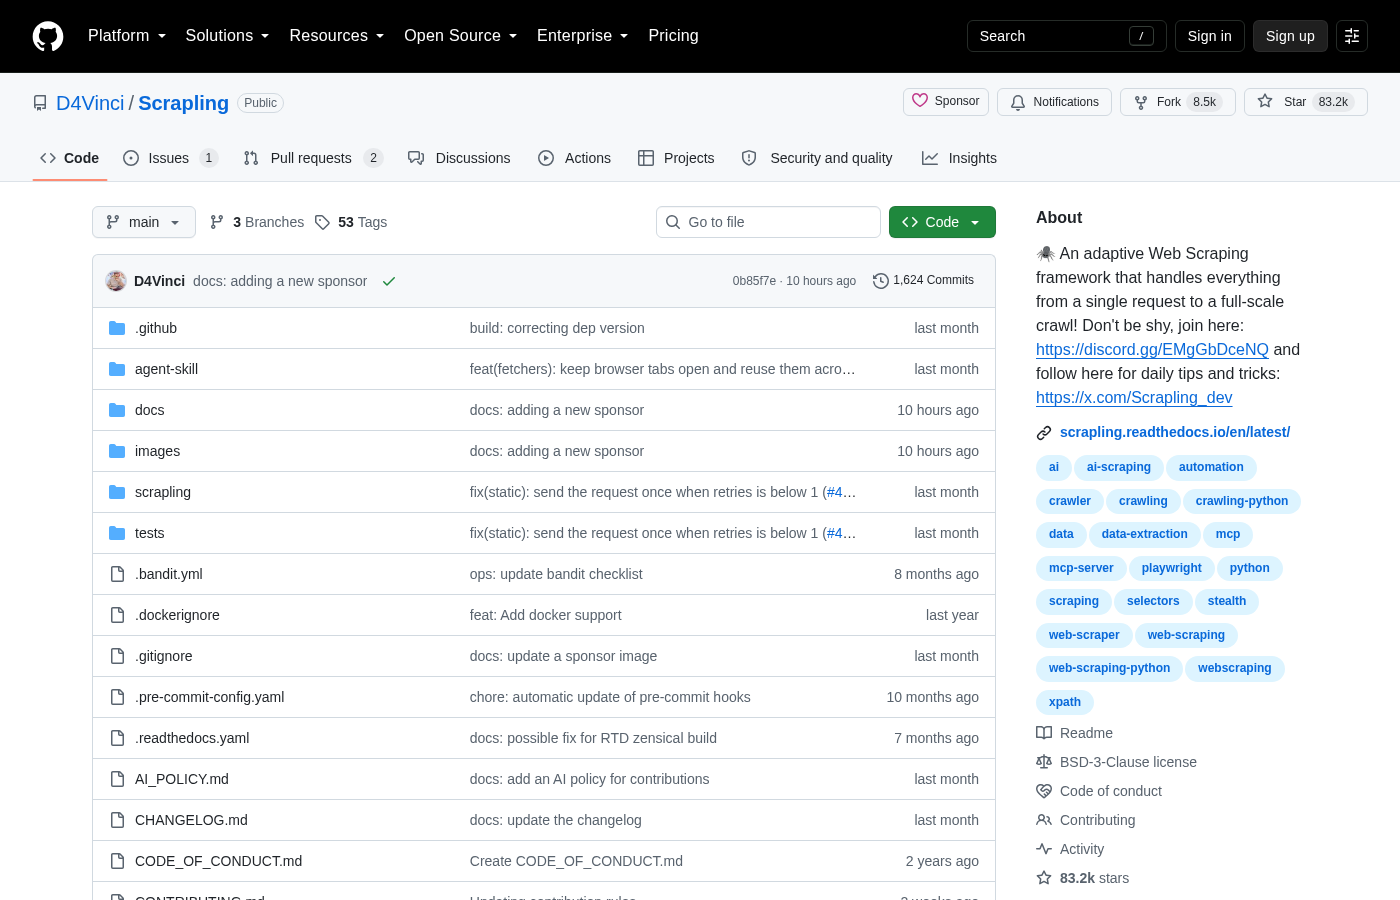
GitHub:82.9K Stars · BSD-3-Clause · Python 3.10+ · 92%测试覆盖率
🔥 痛点:爬虫写完就废了?
写过爬虫的同学都知道,最崩溃的时刻不是代码报错,而是网站改版了。
你以为 selectors 写得很完美,结果人家前端同学一改 DOM 结构,你的爬虫立刻全线罢工。然后你熬夜一个个排查哪个 .container > div:nth-child(3) 失效了,再改一遍——过两周又改了。
更烦的是反爬机制:Cloudflare Turnstile、浏览器指纹检测、TLS 指纹校验……传统爬虫库(requests + BeautifulSoup)在这些面前基本就是裸奔。
直到我发现了 Scrapling——一个能自动适应网站变化的 Python 爬虫框架。82K Star 不是白来的,它真的解决了上面两个核心痛点。
💡 Scrapling 是什么?
一句话:Scrapling 是一个自适应的 Python 爬虫框架,能处理从单个请求到大规模爬取的所有场景。
核心卖点就两个:
⚡ 五分钟上手:从安装到跑通
第一步:安装
# 基础安装(仅解析器)
pip install scrapling

# 完整安装(含所有Fetcher和浏览器支持)
pip install scrapling[all]
scrapling install  # 下载浏览器依赖

# Docker 安装(推荐,包含所有依赖)
docker pull pyd4vinci/scrapling
第二步:最简单的用法(3行代码)
from scrapling import Fetcher

fetcher = Fetcher()
page = fetcher.get("https://quotes.toscrape.com")

# 用 CSS 选择器提取数据
quotes = page.css("div.quote")
for q in quotes:
    text = q.css("span.text::text").get()
    author = q.css("small.author::text").get()
    print(f"{text} —— {author}")
第三步:启动自适应选择器(核心功能)
这是 Scrapling 最牛的功能。先用 StealthyFetcher 打开目标网站,获取元素的「身份指纹」:
from scrapling import StealthyFetcher

# 用隐身浏览器打开网站
page = StealthyFetcher().fetch("https://example.com")

# 获取目标元素(比如产品标题)
target = page.css(".product-title")[0]

# 保存元素的"指纹"到本地
target.save("product_selector.json")

# 下次运行时,即使网站改版,也能自动找到这个元素
from scrapling import Fetcher
page = Fetcher().get("https://example.com")  # 用普通 HTTP 也行

# 自动定位:元素位置变了?没关系,Scrapling 会根据内容相似度找到它
found = page.find("product_selector.json")
print(found.text)
💡 通俗解释:传统选择器像精确的GPS坐标——楼拆了就找不到了。Scrapling的自适应选择器像人脸识别——就算你换了发型、戴了帽子,它还是能认出你。
🏗️ 四层架构:从请求到反爬全覆盖
Scrapling 不是一个库,而是一整套爬虫工具链:
🚀 实战:绕过Cloudflare抓取数据
这是很多爬虫工程师的噩梦。Cloudflare Turnstile 基本能拦住99%的爬虫。但 Scrapling 的 StealthyFetcher 内置了绕过能力:
from scrapling import StealthyFetcher

# StealthyFetcher 会自动处理:
# - Cloudflare Turnstile 验证
# - 浏览器指纹伪装(WebDriver检测)
# - TLS 指纹校验
# - JavaScript 挑战
page = StealthyFetcher().fetch(
    "https://目标网站.com/data",
    wait_selector=".data-table",  # 等待数据加载
    timeout=30
)

# 正常提取数据
table = page.css("table.data-table tr")
for row in table:
    cells = row.css("td::text").getall()
    print(cells)
📊 性能对比:凭什么它这么快?
官方基准测试结果(5000个嵌套元素的文本提取):
自适应元素查找方面,Scrapling(2.3ms)比 AutoScraper(12.58ms)快5.47倍。
🎯 适用场景
⚠️ 注意事项
- Scrapling 是开发者工具,不是图形化软件,需要 Python 基础
- 遵守目标网站的 robots.txt 和服务条款
- 建议使用代理池,避免单IP高频请求被封
- 首次运行
StealthyFetcher会下载浏览器依赖,需要几分钟 - Python 版本要求 3.10+,老版本不兼容
📥 下载与资源
📦 PyPI安装:pip install scrapling
🐙 GitHub:https://github.com/D4Vinci/Scrapling
📖 文档:https://scrapling.readthedocs.io
📥 源码下载:https://pan.quark.cn/s/f1ac12db640d
—— 关注公众号「实用软技」,回复关键字「软件」获取更多开发工具推荐
