智谱GLM-5.3-FlashX发布:速度5倍飞跃,模型自己优化自己
目录
智谱GLM-5.3-FlashX发布:速度5倍飞跃,模型自己优化自己
值友们,大模型赛道又卷出新高度了。智谱AI正式发布GLM-5.3-FlashX–这是GLM-5.3系列的速度加强版,输出速度达到200 tokens/s,相比原版Flash提升5倍。
但更炸裂的不是速度,而是:这个模型帮自己优化了推理系统。
核心数据一览
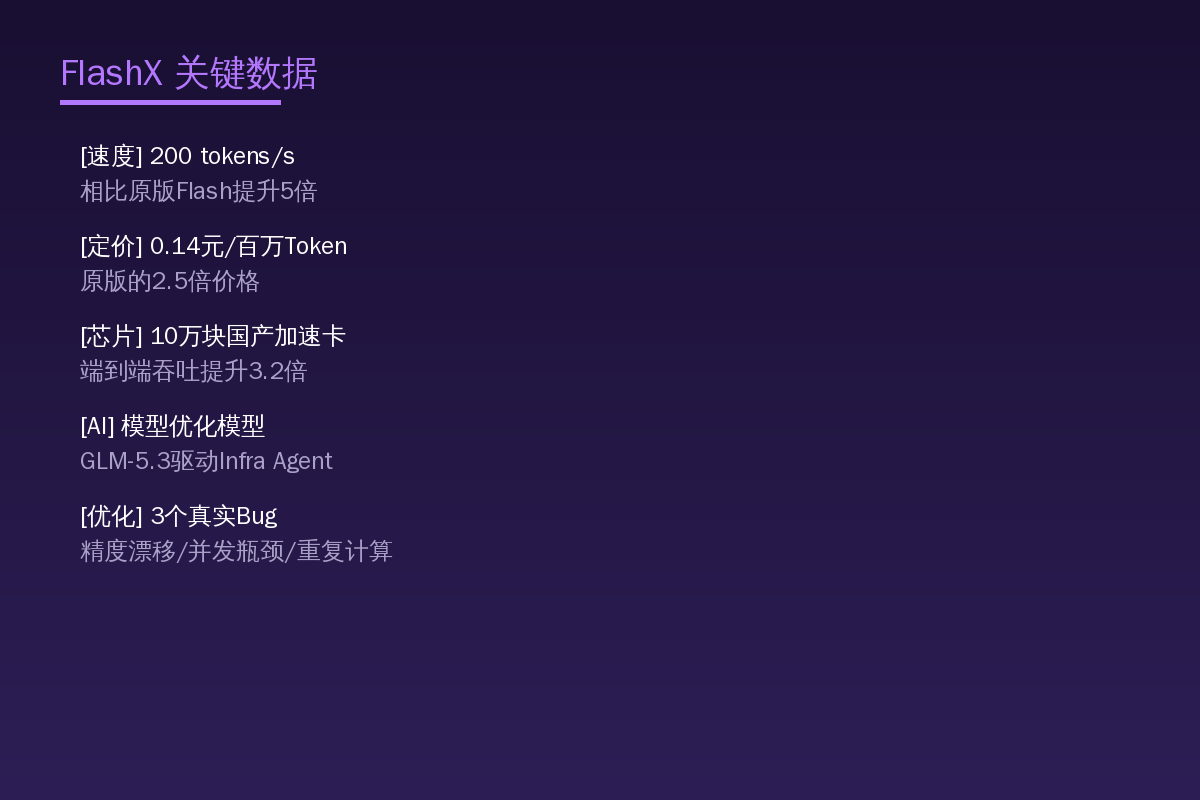
| 指标 | 数据 | 对比 |
|---|---|---|
| 输出速度 | 200 tokens/s | 原版Flash约40 tokens/s |
| 定价 | 0.14元/百万Token | 原版的2.5倍 |
| 部署规模 | 10万+块国产加速卡 | 端到端吞吐提升3.2倍 |
| 优化耗时 | 不到两周 | 从跑通到上线生产 |
| Bug修复 | 3个真实工程问题 | 精度漂移/并发瓶颈/重复计算 |
“模型优化模型”:递归自我改进的最小闭环
智谱CEO唐杰披露了一个关键细节:GLM-5.3-Flash的全部生产推理已运行在超过10万块国产AI加速器上。完成大量优化工作的不是工程师团队,而是一个由GLM-5.3驱动的AI智能体。
干活的主力是模型自己。一个模型在帮忙优化运行它自己的系统。
国产加速器显存容量和带宽有限,软件生态不成熟,很多该有文档的地方只能靠猜。每一步优化都是在做交换:
- 用计算换显存(ReplaySSM)
- 用通信换显存(节点内张量并行)
- 用精度换容量(INT8/FP8/BF16混合缓存)
- 用架构分离换调度自由度(编码-预填充-解码分离)
AI找到的3个真实Bug
智谱构建了一套”密集反馈”机制,让AI智能体直接调用分层验证接口。靠这套机制,它发现并修复了三个真实的工程问题:
| Bug类型 | 问题 | 修复效果 |
|---|---|---|
| 精度漂移 | KDA内核上下文并行路径中TF32舍入误差累积 | 修复已合并到Flash Linear Attention开源项目 |
| 并发瓶颈 | KV缓存传输未与计算并行,DeepEP路径未释放GIL | 开销从超30%降到1%以下 |
| 重复计算 | 解码内核分块方式把同一归一化运算重复做了四遍 | 加速1.71倍 |
对普通用户意味着什么?
你可能会问:这跟我有什么关系?关系大了:
1. API调用更快了。200 tokens/s意味着几乎实时的文本生成体验,做AI写作、代码补全、智能客服场景响应速度质变。
2. 国产芯片跑AI不再是空话。10万块国产加速卡跑通全量线上流量,证明国产算力+国产大模型的组合已经能打。
3. AI工程师的饭碗在变。唐杰说:”工程师不再手写内核,转向设定约束、校验AI输出。”DeepSeek算子工程师也发推感慨:手工写底层算子的价值持续下滑。
课代表总结
GLM-5.3-FlashX的发布不只是”又快了一点”,它验证了一个新范式:模型可以优化自己运行的系统。唐杰称之为”最小的闭环已经存在:模型优化系统,系统运行模型。”
对于开发者来说,如果你正在找一个速度快、价格合理、支持超长上下文的国产大模型API,FlashX值得试试。定价0.14元/百万Token虽然比原版贵2.5倍,但5倍的速度提升在很多场景下是值得的。
国产大模型+国产芯片的双向奔赴,正在悄悄改写游戏规则。值友们,AI时代真的来了。
📂 更多推荐
- 查看更多相关文章:https://www.88531.cn
- 关注公众号「实用软技」获取更多软件推荐和实用技巧
- 所有软件均提供夸克网盘下载,公众号回复「软件」一键获取
