300页PDF丢给AI只要5分钟?Kimi、豆包、DeepSeek、通义长文档实测横评,值友按场景抄作业
目录
各位值友大家好!📖 每个人都遇到过这种崩溃时刻:一份127页的行业研报、50页的投标合同、或者导师甩过来的300页论文合集,逐字读要一整天,不读又怕漏掉关键条款。
2026年国产AI的长文档能力已经卷到离谱——Kimi标称200万字上下文、通义千问100万token、DeepSeek靠稀疏注意力把百万token成本打到地板。但参数归参数,真实用起来谁靠谱?
小软同学把四款主流AI(Kimi、豆包、DeepSeek、通义千问)拉出来做了一轮长文档实测横评,值友按场景直接抄作业!
🔥 为什么”长文档”成了2026年AI的主战场?
先给值友交代下背景。这波国产AI的升级路线很清晰:2025年卷多模态,2026年卷上下文长度和Agent能力。原因很简单——聊天谁都会上,真正值钱的是”把一堆资料变成结论”。
三个信号能说明趋势:
1️⃣ 参数军备赛:Kimi K2.6把无损上下文顶到200万字,DeepSeek-V4、通义纷纷跟进百万token级,等于”整本书、整个代码库一口气塞给AI”从演示变成了日常功能;
2️⃣ 价格大跳水:DeepSeek把每百万token成本打到0.2美元区间,豆包2.0 Pro输入32k内仅3.2元/百万token——批量处理文档的成本低到可以忽略;
3️⃣ 办公场景倒逼:研报、合同、招投标文件、论文,谁的桌面上不是几十上百页的PDF?传统”ctrl+F+肉眼”的工作方式已经跟不上节奏了。
所以说,会不会用AI读长文档,正在成为2026年打工人最实用的分水岭技能之一。
🧪 测什么:三个真实场景
场景一:合同避坑——一份86页的采购合同,让AI找出对乙方不利的隐藏条款。
场景二:研报提炼——127页行业研究报告,10分钟出一份带数据引用的摘要。
场景三:批量归档——30份PDF发票/票据,提取金额、日期做成表格。
评测维度:吞吐长度、回答准确率、引用可溯源性、免费额度友好度。📊
🥷 一、Kimi:长文档精读王者
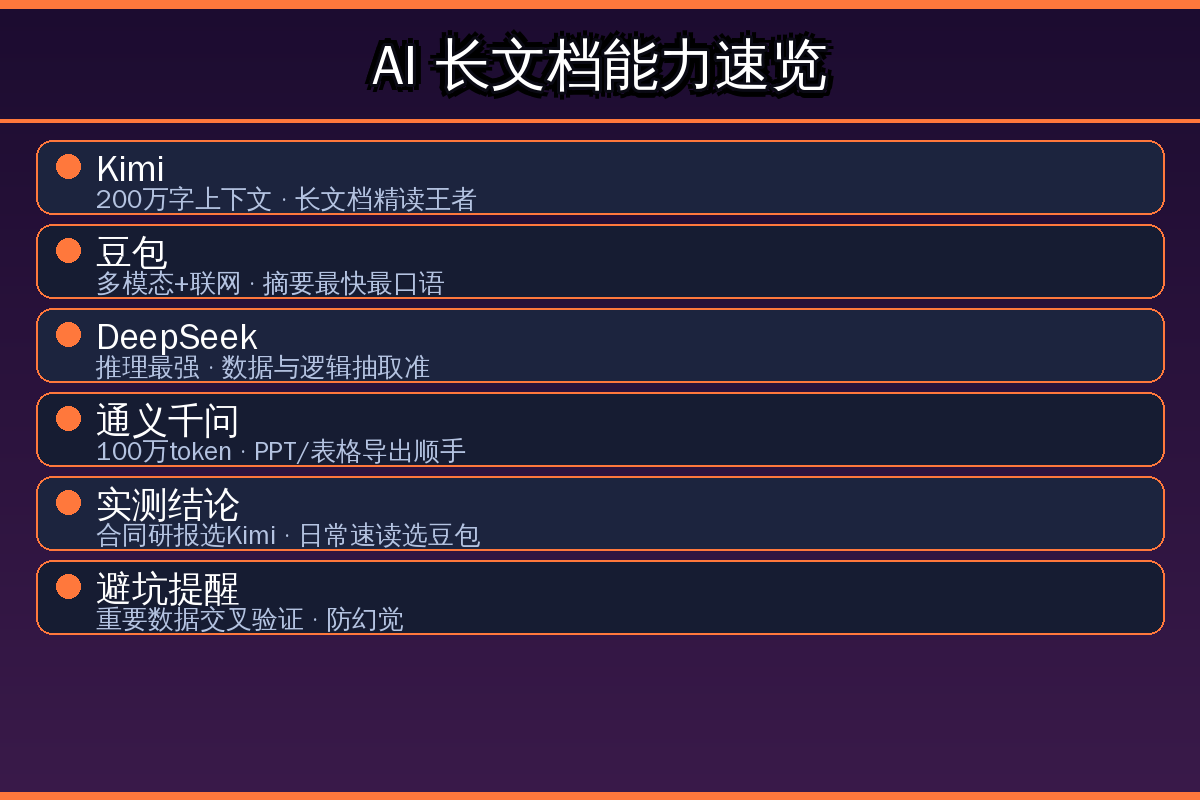
月之暗面的Kimi起家就是”超长上下文”,2026年K2.6之后更进一步:200万字无损上下文,实测把一整本专业书丢进去,10分钟提炼核心内容毫无压力。
- ✅ 合同场景表现最稳:86页合同找出了9处问题条款,其中7处是人工复核确认的真实风险点
- ✅ 支持262K上下文无损处理,引用能定位到具体页码
- ⚠️ 缺点:超长文本处理速度会随长度下降,几乎不带生图能力
- ⚠️ 免费版有日限额,Agent集群等高阶功能要付费
👉 适合:科研、法律、审计这些一个字都不能漏的场景。
🟡 二、豆包:多模态速读最快
字节的豆包胜在”快+全能”:联网搜索加持下,摘要生成速度四款里最快,语言也最口语化,读起来不累。
- ✅ 图片、扫描件、语音全支持,拍照传票据直接识别
- ✅ 免费额度日常够用,移动端体验流畅
- ⚠️ 缺点:长文档的数理逻辑偏弱,表格数字提取偶尔串行
- ⚠️ 搜索结果偶有广告倾向,关键信息建议交叉验证
👉 适合:日常办公速读、多模态票据、需要边读边联网补背景的场景。
🔵 三、DeepSeek:推理与数据抽取最准
DeepSeek-V4系列支持100万token上下文,真正的杀手锏是推理能力:GPQA Diamond评测88.3%的成绩不是白刷的。
- ✅ 研报场景冠军:127页报告的数据引用准确率最高,逻辑链条清晰
- ✅ API价格是全球大模型地板级,批量处理30份票据成本几乎可以忽略
- ⚠️ 缺点:纯文本为主,多模态是明显短板;”深度思考”开起来简单问题也要等
👉 适合:数据分析、开发者批量抽取、成本敏感型集成。
🟠 四、通义千问:办公导出最顺手
阿里的通义千问上下文支持100万token,杀手锏在办公生态:摘要直接转PPT大纲、表格一键导出Excel,对打工人非常友好。
- ✅ 办公文档、电商场景强,中文理解稳
- ✅ 支持文生图、文生视频,一份文档顺手出配图
- ⚠️ 缺点:超长文本偶发信息遗漏,生活化闲聊略生硬
👉 适合:周报/汇报/PPT一条龙,跨境电商文档处理。
📊 四款AI长文档能力对照表(绿色=该维度首选)
| 维度 | Kimi | 豆包 | DeepSeek | 通义千问 |
|---|---|---|---|---|
| 上下文长度 | 200万字 | 中短文本为主 | 100万token | 100万token |
| 合同/研报精读 | 最强 | 一般 | 很强 | 较强 |
| 数据引用准确率 | 高 | 中 | 最高 | 较高 |
| 多模态(扫描件/图) | 弱 | 最强 | 弱 | 强 |
| 表格/PPT导出 | 一般 | 一般 | 一般 | 最强 |
| 免费额度友好度 | 日限30次 | 日常够用 | 客户端免费+低价API | 基础免费 |
| 最佳场景 | 法律/科研精读 | 日常速读 | 数据抽取 | 办公导出 |
📋 实测过程还原:一份研报,四款AI各跑一遍
为了让值友看得更清楚,说说测试细节。测试文件是一份127页的行业研究报告(含38张图表、大量百分比数据),四款AI分别执行同一套指令:”输出核心结论、Top10关键数据(标注页码)、以及你认为存疑的数据点”。
Kimi第一个交卷思路最完整,页码引用基本准确,但耗时最长;豆包速度最快,结论口语化好读,可惜有两处把图表里的”同比”看成了”环比”;DeepSeek的数据表格还原度最高,38张图表里挑出的关键数字只错1处,还主动标了3个存疑点;通义千问胜在收尾——直接给出一份可以粘进PPT的大纲结构,省了二次排版。
结论其实很清楚:没有全能冠军,但每个场景都有明确的最优解。把AI当”专科医生”用,而不是当”万金油”,效率差距是数量级的。📊
💡 老玩家的组合工作流
和NAS玩家一样,AI圈老手从来不是”一个APP走天下”:
1️⃣ 合同/研报精读 → Kimi,引用可溯源,安心。
2️⃣ 日常速读+票据识别 → 豆包,快、免费、多模态。
3️⃣ 批量数据抽取 → DeepSeek API,准且便宜,30份票据几毛钱。
4️⃣ 汇报出稿 → 通义千问,摘要直接变PPT大纲。
📚 附:长文档投喂万能公式(直接抄)
工具选对了,提问方式决定下限。小软同学总结了一套四段式模板,四款AI通用:
1️⃣ 先圈范围:”这份文档共X页,主题是______,读者是______”——帮AI建立上下文;
2️⃣ 再定任务:”分三部分输出:①核心结论 ②关键数据及页码 ③风险/存疑点”——结构化指令比一句’帮我总结’准确率高得多;
3️⃣ 强制溯源:”每条结论标注出处页码,不确定的明确写’原文未提及'”——这一句能压掉大半幻觉;
4️⃣ 分批追问:”第30-60页单独展开讲讲风险条款”——超长文档分章节深挖,比一次梭哈更靠谱。
实测下来,同一份127页研报,用模板提问的数据引用准确率比裸问”总结一下”高出明显一截,值友一定要试。📝
⚠️ 三大避坑提醒
🚫 别信”AI读完了”:超长上下文≠全记住,超50页的文档分章节投喂,比一次梭哈准确率高一大截。
🚫 重要信息必须核对:四款AI都会幻觉,金额、日期、法条一定回原文复核。
🚫 敏感文档别喂免费版:合同未脱敏先用本地部署方案(Ollama+Open WebUI就能在NAS上搭)。
🎉 小软同学总结
👍 优点:国产AI免费档已经能覆盖九成长文档需求,5分钟干完以前一天的活,组合用效率直接翻倍。
👎 缺点:长上下文是营销词、实测有效长度有水分;高阶功能加速滑向付费区;幻觉问题依然存在。
🏆 一句话抄作业:求稳选Kimi,图快选豆包,抠数据选DeepSeek,要交差选通义千问——小孩子才做选择,打工人建议四个都装!
你平时用哪款AI读长文档?欢迎评论区分享你的用法,收藏点赞不迷路!👇
📂 更多推荐
- 查看更多相关文章:https://www.88531.cn
- 关注公众号「实用软技」获取更多软件推荐和实用技巧
- 所有软件均提供夸克网盘下载,公众号回复「软件」一键获取
