LEANN新手教程:13.1k Star开源神器,笔记本秒变私人知识库,6000万文档只占6GB(MLSys 2026最佳论文)
LEANN新手教程:13.1k Star开源神器,笔记本秒变私人知识库,6000万文档只占6GB(MLSys 2026最佳论文)
哎,说到”个人知识库”,你是不是也踩过这些坑?
电脑里几十个 PDF、一堆 Markdown 笔记、多年的微信聊天记录、浏览器历史……想问 AI 一句”我上个月那份合同里违约金怎么写的”,结果要么把文件全喂给在线大模型(隐私裸奔),要么自己搭向量数据库——光是 embedding 索引就吃掉几百 GB 硬盘,笔记本风扇狂转。
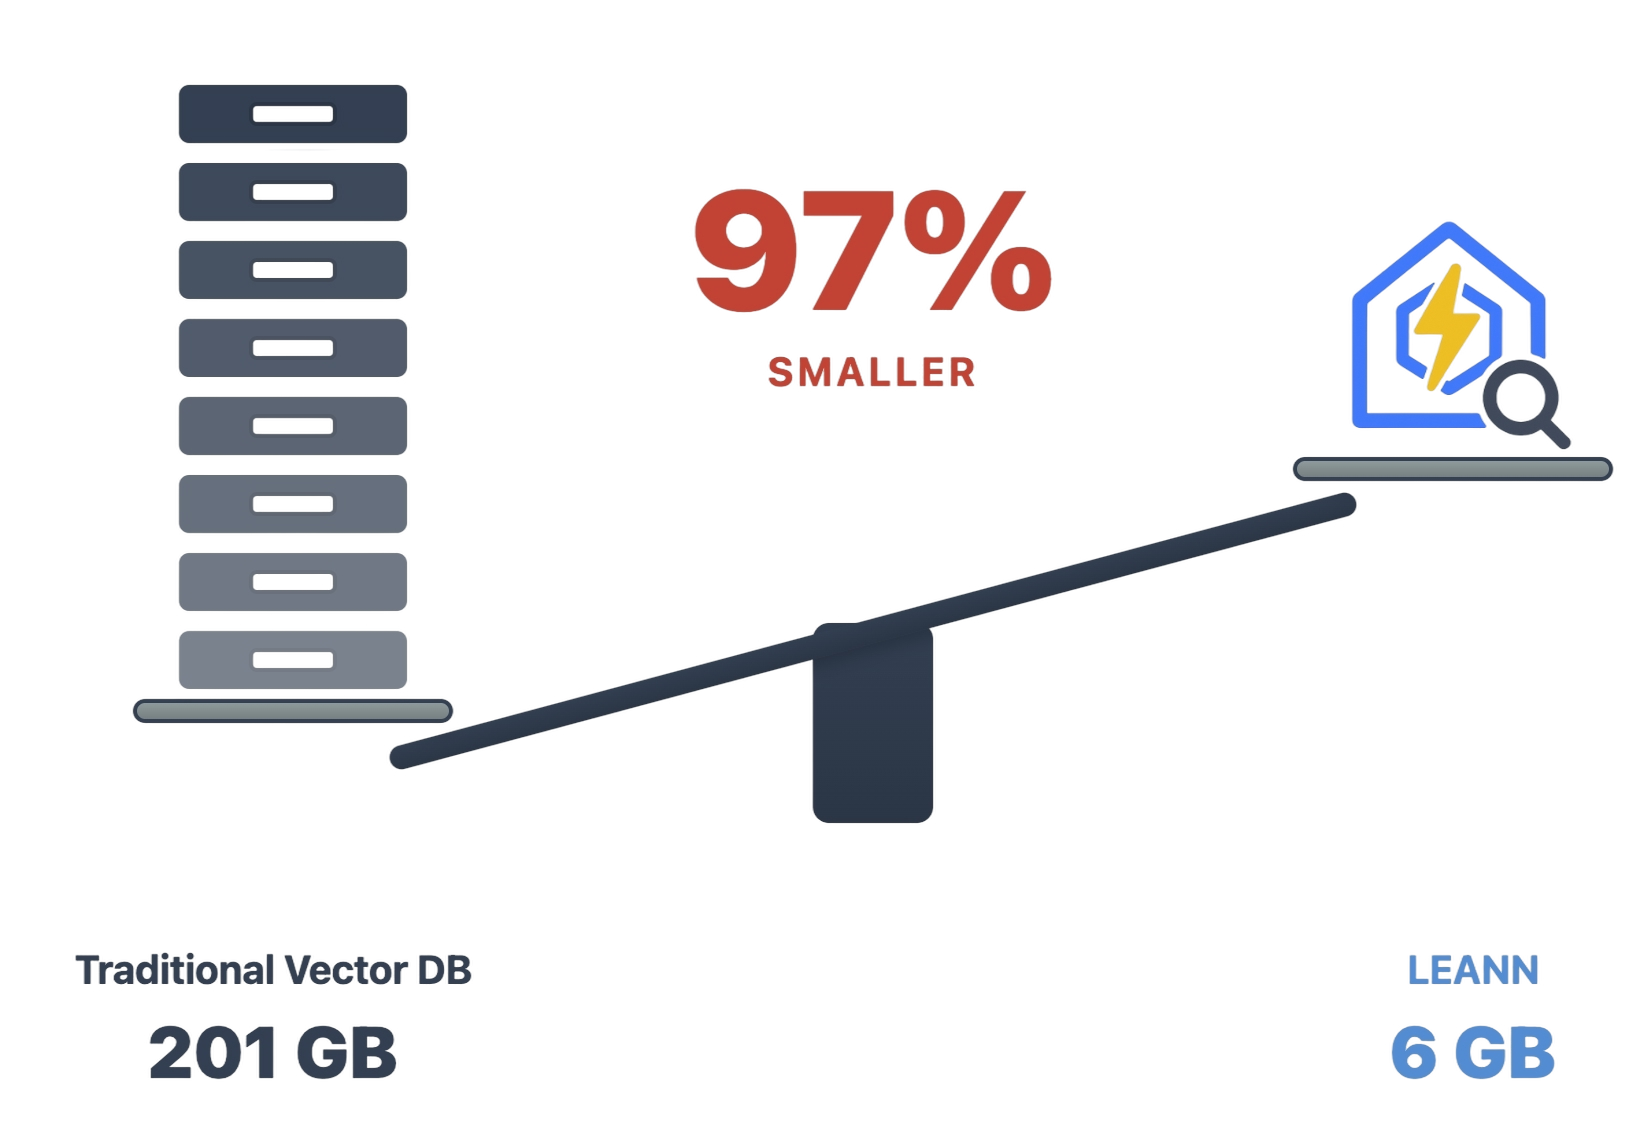
传统向量数据库就是这么笨重:索引 6000 万条文本块,动辄 201GB 起步。大部分人不是不想做 RAG(检索增强生成,简单说就是”先搜资料再让 AI 回答”),是硬盘和钱包都撑不住。
今天介绍的这个项目,直接把这个问题掀翻了。
一句话简介
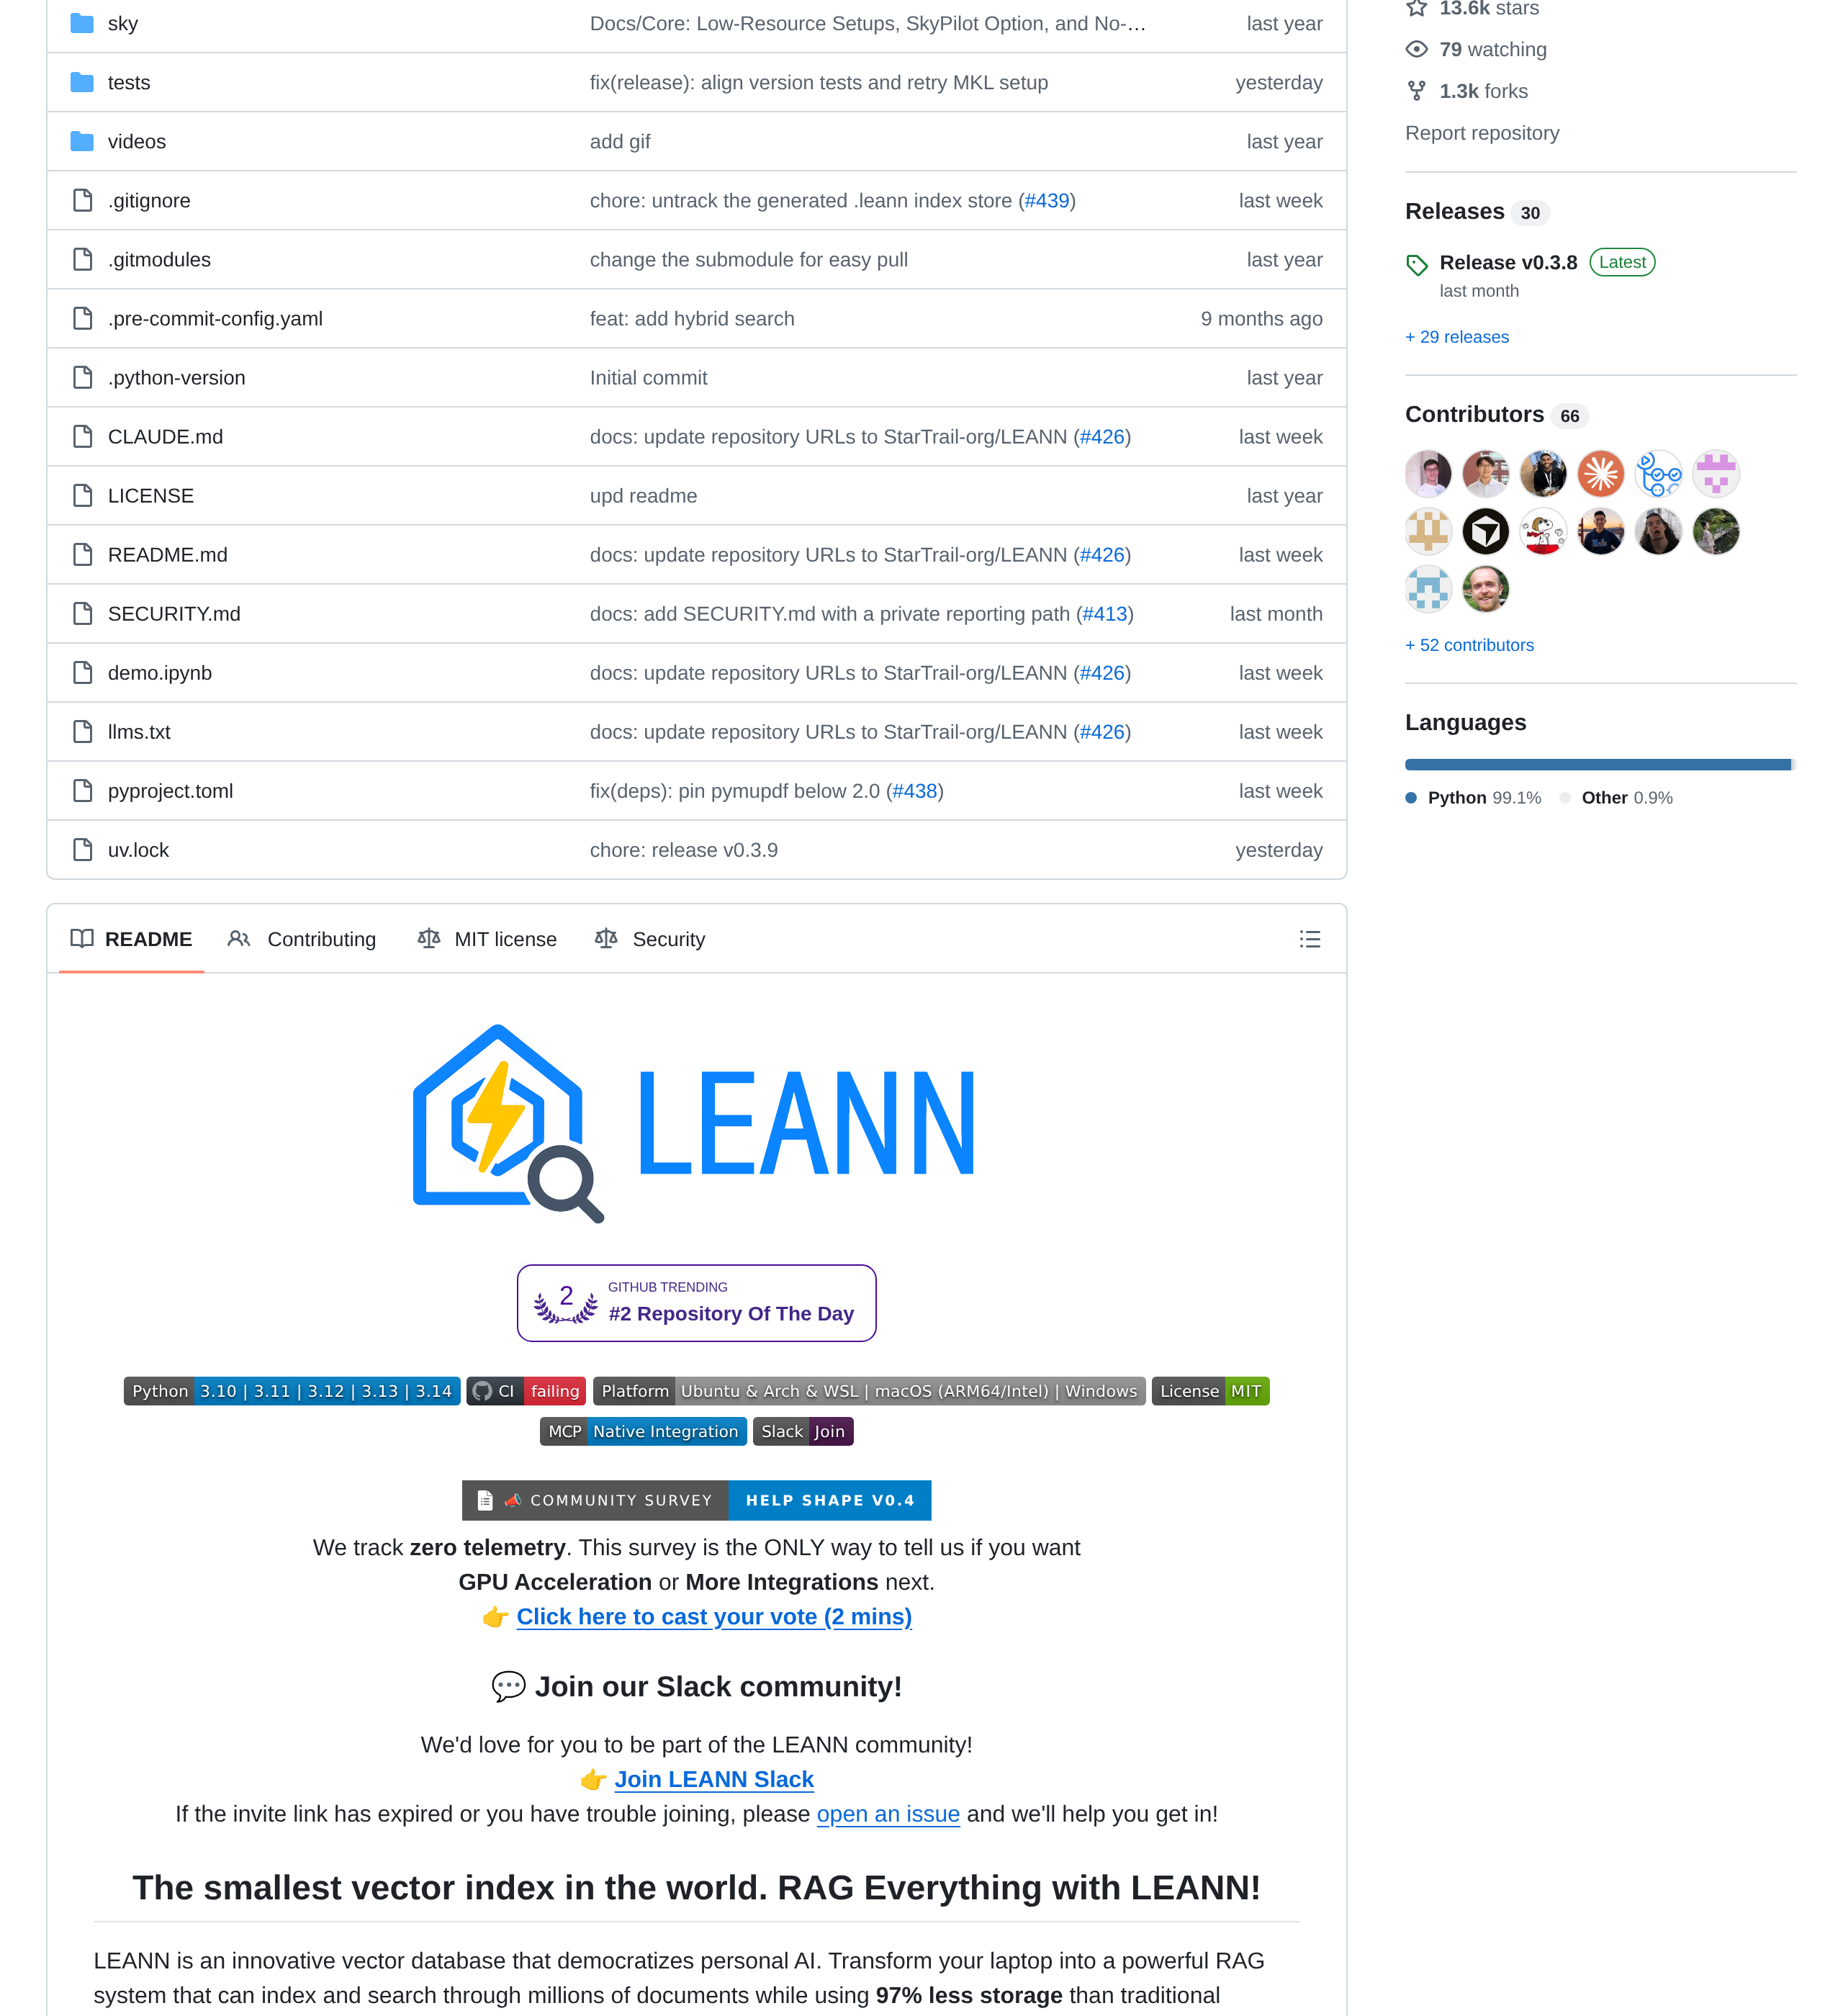
LEANN 是伯克利 Sky 计算实验室开源的超省空间向量索引,刚拿下 MLSys 2026 最佳论文,GitHub 上已经 13.1k Star。它的本事:索引 6000 万文本块只要 6GB(传统方案要 201GB),省 97% 存储,检索精度还不掉。
更关键的是:全程跑在你自己的笔记本上,数据不出本机,不联网、不花一分钱 API 费。
它是怎么做到的?核心思路一句话:传统方案把每段文字的向量(一串数字指纹)全存下来,LEANN 只存文档本身和一张”关系图”,向量用的时候现场重算,配合智能剪枝,硬盘占用直接砍掉 97%,检索质量不变。
它能拿来干嘛?
官方支持的玩法(都是本地跑):
- 文档问答:PDF、TXT、MD 扔一个文件夹,直接问”这篇论文的核心方法是什么”
- 微信聊天记录检索:官方叫”WeChat Detective”,找回你聊过的金句
- 浏览器历史回放:三个月前看过的一个网页,语义搜回来
- ChatGPT / Claude 对话存档搜索:自己的 AI 对话历史变成可检索记忆
- 代码库语义搜索:还给 Claude Code 提供 MCP 接入,让它找代码不靠瞎 grep
环境准备(5分钟)
支持 Ubuntu/Arch/WSL、macOS、Windows。Python 3.10+ 都行。
第一步,装 uv(一个超快的 Python 包管理工具,Rust 写的,装过一次后面都顺滑):
curl -LsSf https://astral.sh/uv/install.sh | shWindows 用户去 uv 官方文档 下载安装包即可。
安装 LEANN(跟着敲就行)
把源码克隆下来(想直接用 pip 装的可以跳过克隆,但克隆了才有官方示例和 demo 数据):
git clone https://github.com/StarTrail-org/LEANN.git leann
cd leann

# 创建虚拟环境并激活
uv venv
source .venv/bin/activate

# 安装 LEANN
uv pip install leann

# Linux 没有 NVIDIA 显卡的机器,用 CPU 版:
# uv pip install "leann[cpu]"
Windows 用户如果 git clone 太慢,可以用镜像:
git clone https://ghproxy.net/https://github.com/StarTrail-org/LEANN.git leann踩坑提示(Linux):如果后面 leann build 报 Security Violation [pathsec.open]: refusing multiply-linked file,这是 uv 默认用硬链接安装、和 llama-index 自带的 nltk 文件校验冲突,重装一次就好:
UV_LINK_MODE=copy uv pip install --reinstall leann跑通第一个本地知识库问答
官方自带一个 demo,data/ 目录里放了几篇论文和一个中文技术报告。直接问它:
source .venv/bin/activate
python -m apps.document_rag --query "What are the main techniques LEANN explores?"
第一次跑会自动下载 embedding 模型(几百 MB),耐心等一下。跑完它会先检索相关段落,再生成回答,并引用出处。
换成你自己的文档目录,把 --data-dir 指过去就行:
# 索引你的全部笔记
python -m apps.document_rag --data-dir "~/Documents/Notes" --query "我去年写的关于 Kubernetes 的总结要点是什么?"

# 只索引 md 和 py 文件
python -m apps.document_rag --data-dir "./docs" --chunk-size 256 --file-types .md .py
不带 --query 直接运行,就进入交互模式,可以连续追问,输 quit 退出。
进阶:完全离线,一个字节都不外传
默认走 OpenAI 接口做生成,想全离线就配合 Ollama(本地跑大模型的工具):
# 装 Ollama 并拉一个轻量模型(1B 参数,笔记本无压力)
curl -fsSL https://ollama.ai/install.sh | sh
ollama serve &
ollama pull llama3.2:1b

# 用 Ollama 做问答
python -m apps.document_rag --llm ollama --llm-model llama3.2:1b --query "总结这份文档"
国产模型也都能接,任何 OpenAI 兼容接口都行,比如 DeepSeek、硅基流动、智谱,设置 OPENAI_BASE_URL 和 OPENAI_API_KEY 就完事。
常见问题
Q:没有 GPU 能用吗?
能。embedding 和小模型问答 CPU 都跑得动,就是索引大目录时慢一些。Linux 记得装 leann[cpu]。
Q:Windows 原生能装吗?
理论上支持(需要 VS2022 Build Tools + vcpkg),但依赖编译比较折腾。新手建议直接 WSL2,一劳永逸。
Q:和 RAGFlow、Dify 这类工具有什么区别?
那些是”平台”,LEANN 是”索引引擎”。它的杀手锏是存储压缩率和隐私,适合个人笔记本场景,而不是团队服务器部署。
Q:检索质量真的不掉吗?
论文里的基准测试显示和传统重型方案持平,笔者实测小规模文档库体验一致。它靠”用时重算向量”换空间,代价是每次查询多耗一点 CPU 算力。
下载与资源
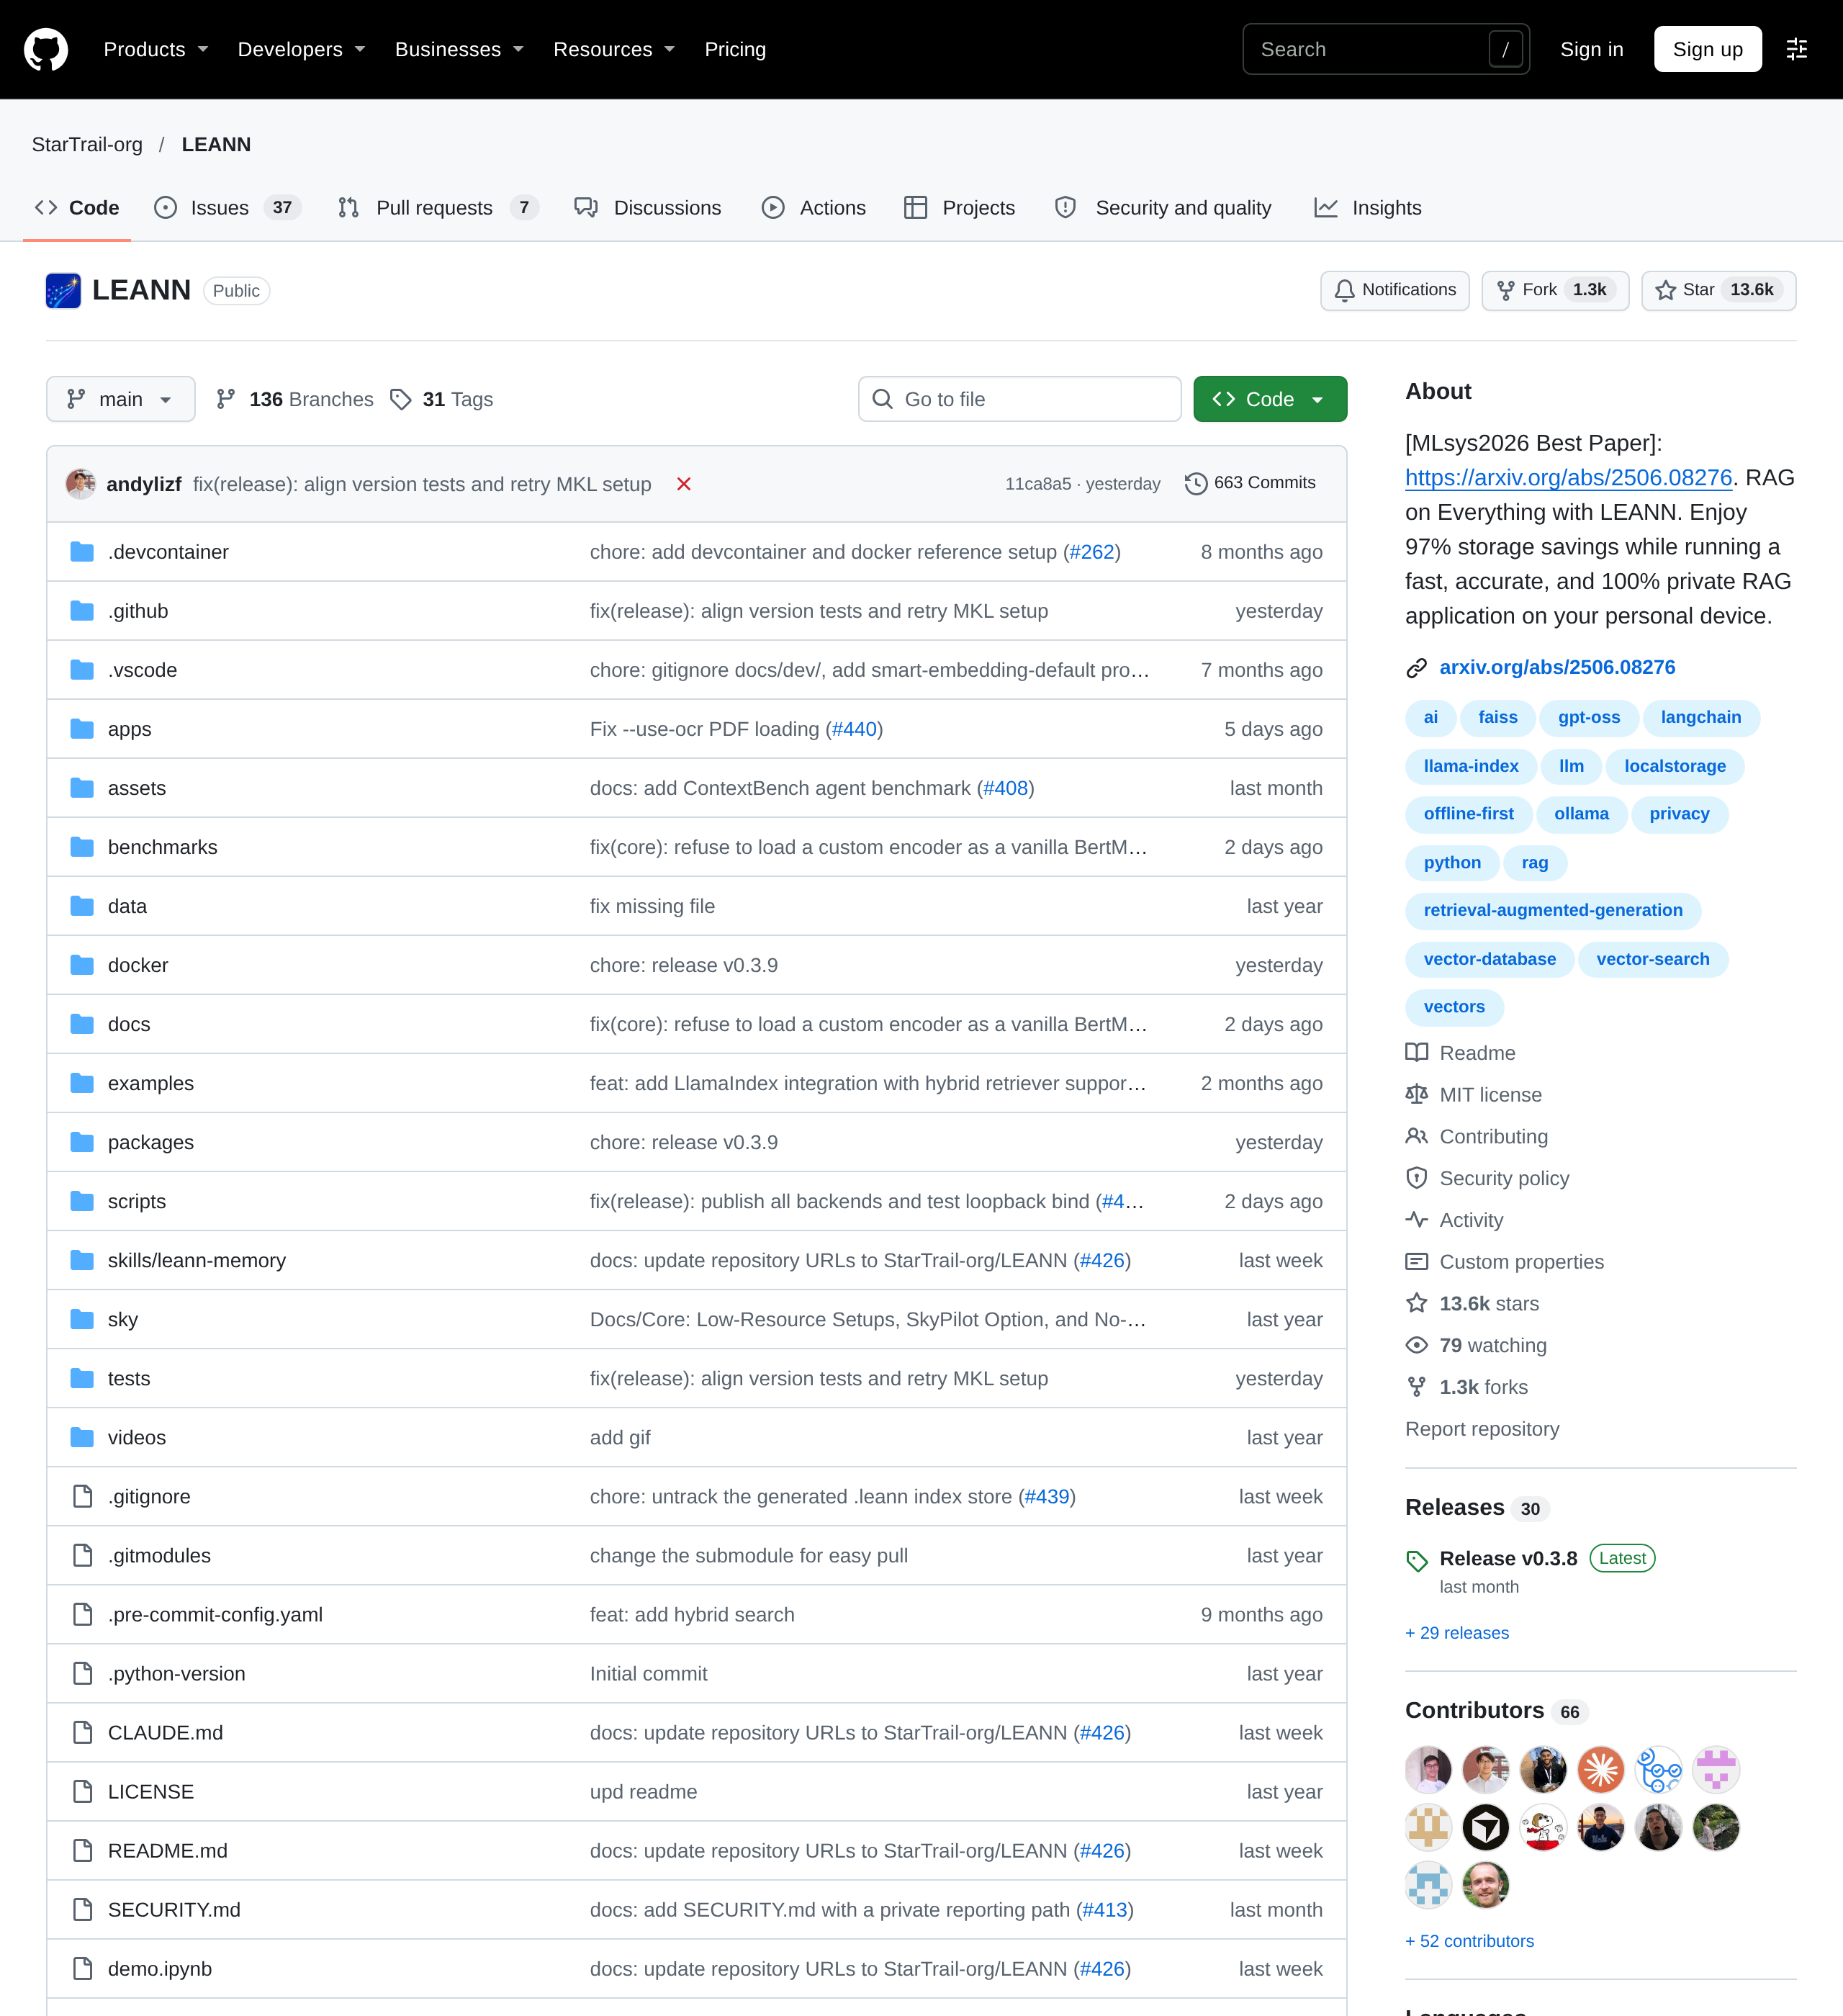
GitHub 源码(13.1k Star,MIT 协议):
https://github.com/StarTrail-org/LEANN
源码包直链(GitHub 直连慢时用镜像,把前缀拼在链接前面):
https://ghproxy.net/https://github.com/StarTrail-org/LEANN/archive/refs/heads/main.zip
论文地址:
https://arxiv.org/abs/2506.08276
一行命令安装(PyPI):
uv pip install leann
写在最后
说实话,现在本地 RAG 工具不少,但大多在”能用”和”好用”之间反复横跳。LEANN 是少见的把”个人设备上真的能跑”做到极致的项目——97% 的存储节省不是营销话术,是有最佳论文背书的硬指标。配合 Ollama,你的笔记本就是一台不联网的私人 GPT,所有聊天记录、笔记、合同都成了可问的知识库。
隐私敏感的读者(比如律师、医生、研究员),这个项目值得你花一下午折腾。
关注公众号:「实用软技」,在公众号窗口里回复关键字“软件”即可免费获取
