星标数:40408★ Fork数:3475 《PageIndex:基于树状索引与推理的无向量RAG引擎》
PageIndex 是一个无向量、基于推理的 RAG 引擎,它模仿人类的阅读方式,提供可追溯、可解释、上下文感知的检索,无需向量数据库,也无需分块(chunking)。
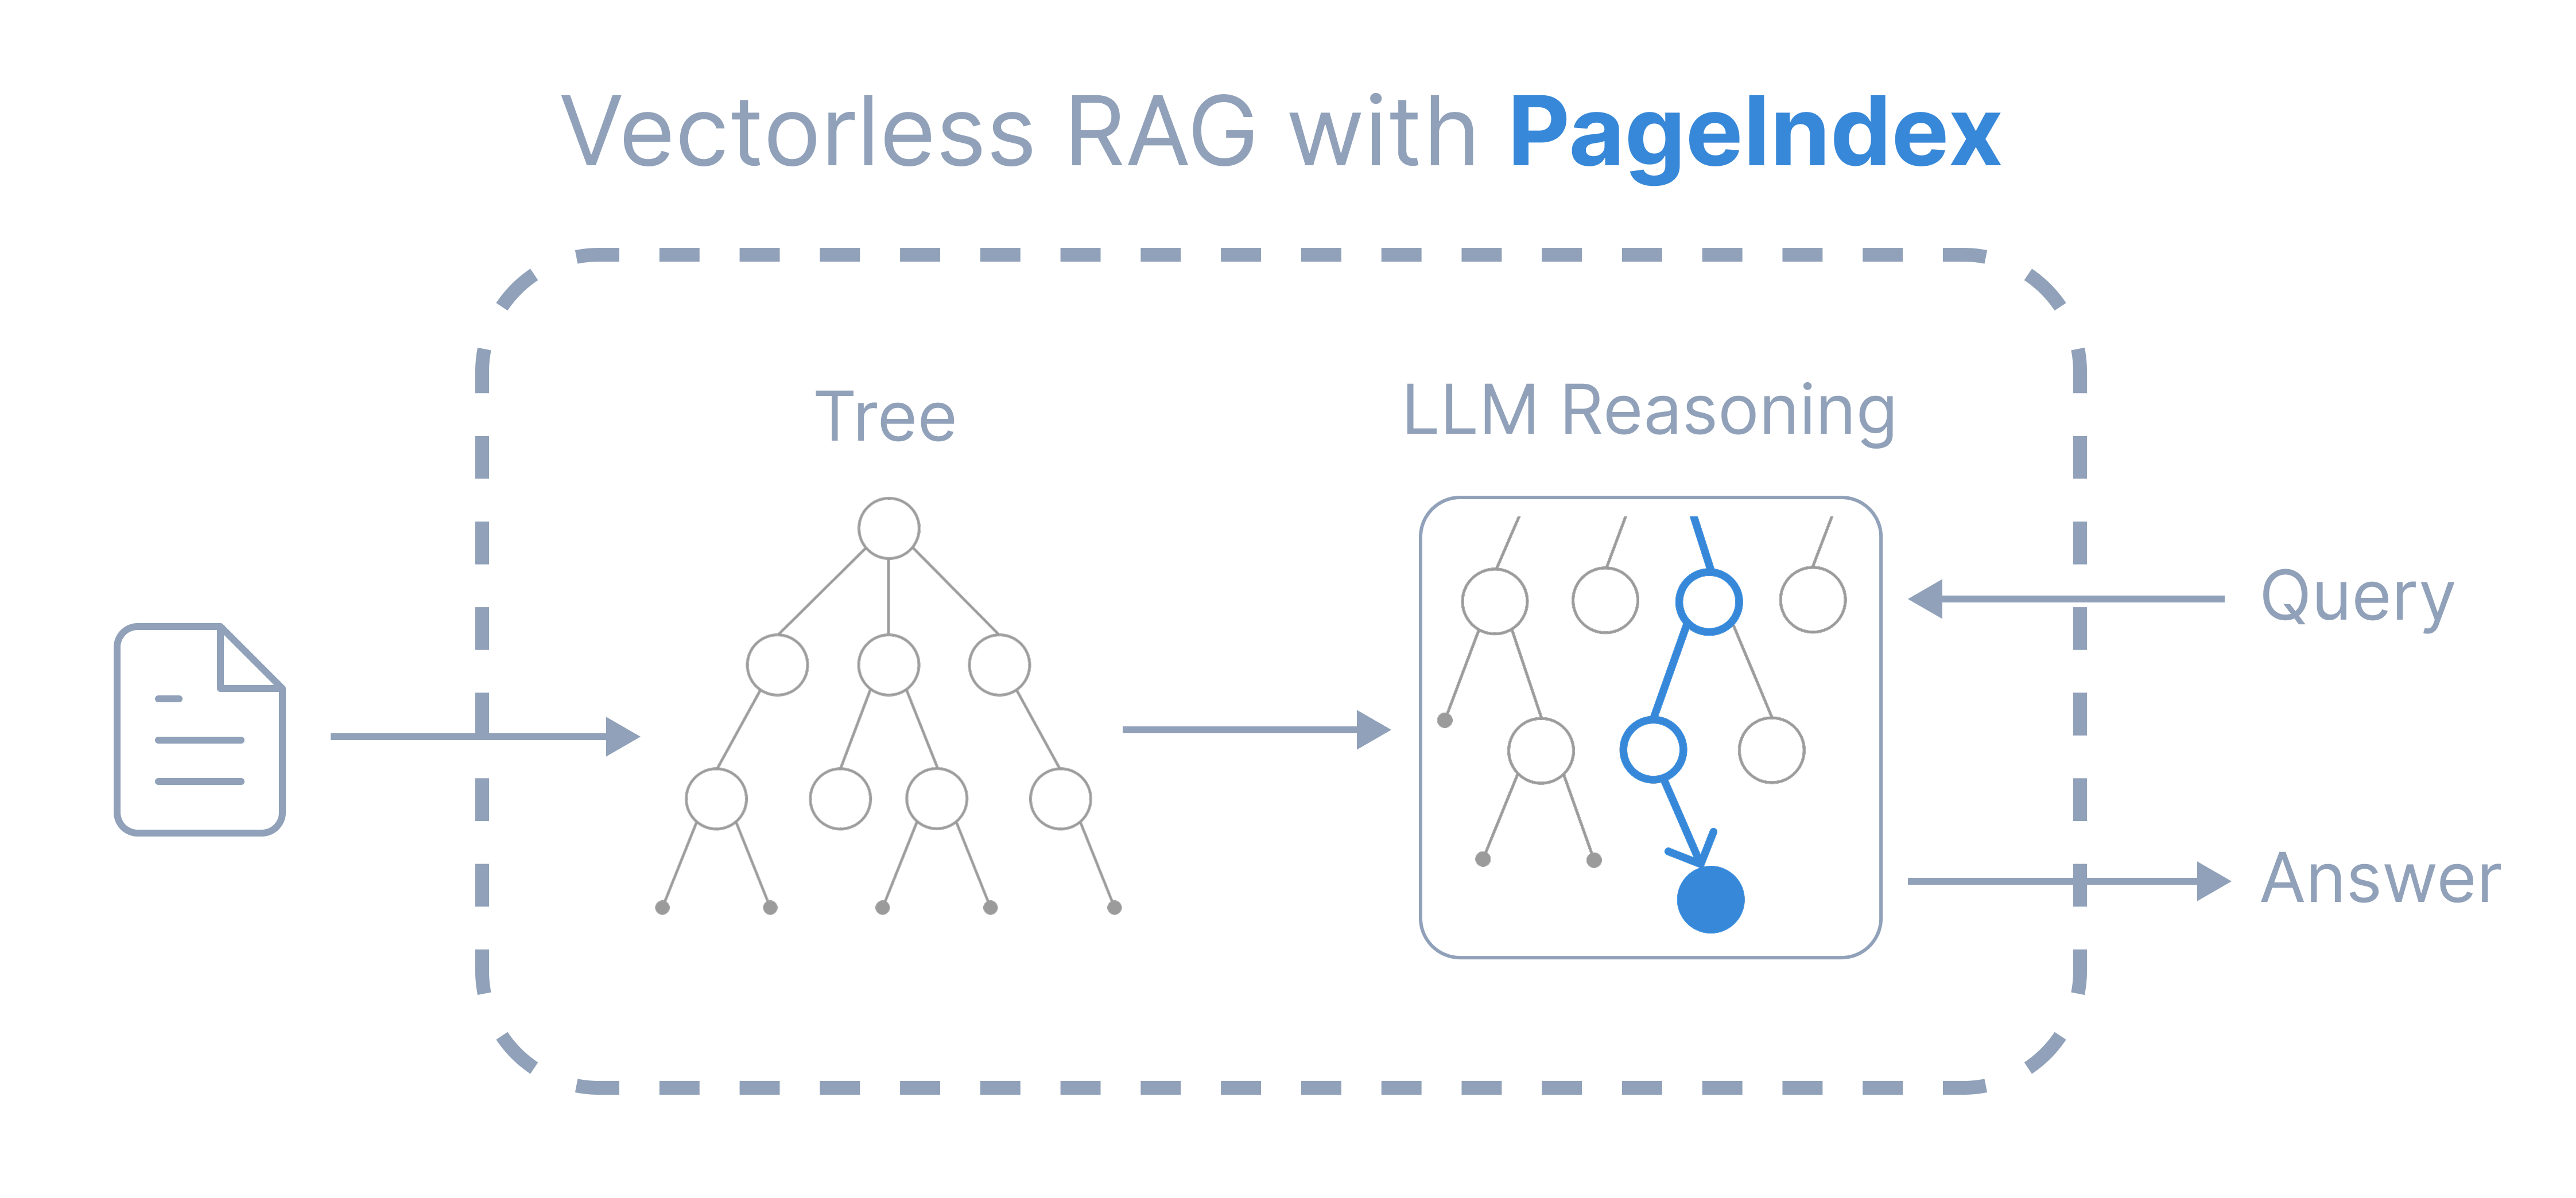
你是否对长而复杂的文档上向量数据库的检索准确率感到沮丧?基于向量的 RAG 通过语义相似度进行检索,但相似 ≠ 相关——检索真正需要的是相关性,而相关性需要推理。在需要上下文理解、领域专业知识和多步推理的专业文档上,相似度搜索会漏掉那些相关但不相似的内容,却返回那些相似但不相关的结果。
受 AlphaGo 启发,PageIndex 用层级树状索引替代向量索引,让 LLM 像人类专家翻阅并阅读长报告中正确章节那样,通过推理在索引中穿行。检索分为两步:先为每份文档生成树结构索引,再由 agent 化地用 LLM 推理搜索这棵树。它适用于财报、法律文书、监管申报、技术手册、医学文献、学术教材,以及任何冗长复杂的专业文档。
主要特点
- 基于推理的 RAG,无需向量数据库、无需分块
- 上下文感知检索,可纳入对话历史、领域知识等完整上下文
- 检索结果可追溯到明确引用,而非不透明的“凭感觉检索”
- 用树索引替代向量索引,用 LLM 推理替代语义相似度搜索
- 提供 PageIndex SDK,支持本地与云端两种模式,也可通过 Page Search API 等接入
快速开始
pip install -U pageindeximport os
from pageindex import PageIndexClient
os.environ["OPENAI_API_KEY"] = "your-openai-key"
client = PageIndexClient(
index="gpt-6-luna", # model to build the tree index
chat="gpt-6-sol", # model to search the tree
)
doc_id = client.submit_document("report.pdf")["doc_id"]
answer = client.chat("What was the 2023 operating margin?", doc_id=doc_id)
print(answer)关于模型选择:index= 使用基础模型即可,因为树结构本身从文档版式中提取,不依赖 LLM;chat= 建议使用你能负担得起的最强模型,由它搜索树来检索信息。
📊 本项目 GitHub 星标数:40408。最后更新:2026-11-05,发布:2026-11-05。项目地址:https://github.com/VectifyAI/PageIndex

