Claude Code封号潮下,国产AI编程怎么选?GLM-5.3深度实测:开源编程SOTA+1M上下文+闲时半价,四笔账算清值友再上车
目录
Claude Code封号潮下,国产AI编程怎么选?GLM-5.3深度实测:开源编程SOTA+1M上下文+闲时半价,四笔账算清值友再上车
值友们,最近AI编程圈是真的不太平:Claude Code封号潮一波接一波,前脚刚有值友在纠结要不要换DeepSeek Harness,后脚国产大模型又扔出一张王炸——智谱GLM-5.3。发布即登HN热榜(812分热议),官方口号相当硬气:当前编程能力最强的开源模型。
这货到底是不是真材实料?Coding Plan订阅划不划算?和DeepSeek、Kimi比怎么选?课代表把公开基准、价格体系、接入成本三方面拆开,四笔账一次算清,看完你再决定要不要掏钱。📊
一、GLM-5.3强在哪:同一基座,后训练”炼”出50%提升
先说一个反直觉的点:GLM-5.3和GLM-5.2用的是同一个基座模型(730B MoE,激活约70B),所有提升都来自后训练Scaling——官方搭了一套能端到端合成任务环境的流水线,研究智能体从真实工作里收集任务模式,变成可运行、可验证的长程任务环境,再用这些环境做强化学习。官方内部评测Z.ai Code Bench上编程体感直接提升50%:Max档位准确率23.4%→34.5%,而且输出Token反而更少(96K→75K),又快又省。
公开基准更能说明问题:
| 基准 | GLM-5.2 | GLM-5.3 | 说明 |
|---|---|---|---|
| Terminal-Bench 3.0 | 4.6 | 28.3 | 真实终端环境完成复杂任务,开源SOTA断层第一 |
| DeepSWE v1.1 | 46.2 | 66.9 | 长程软件工程、持续修改代码 |
| Agents’ Last Exam | 23.8 | 28.5 | 跨工具协作长程任务,开源第一 |
| Z.ai Code Bench(自研) | 23.4%(96K Token) | 34.5%(75K Token) | 贴近真实用户的本地开发环境评测 |
| CyberGym(漏洞发现) | 77.2% | 84.5% | 超GPT-5.6 Sol(83.6%),当前最佳 |
横向对比闭源大佬:High档位下GLM-5.3用约5万Token做到31.4%,超过Claude Opus 4.8(29.5%,还要烧12万Token)——相当于用1/2的Token干翻上代闭源旗舰。离当前最强的Claude Fable 5(Max档39.5%)还有差距,但这个追赶速度,值友们应该都懂意味着什么。🧮
彩蛋能力:GLM-5.3在后训练中”涌现”了网络安全能力,给国内安全团队在269个项目里挖出2436个漏洞(含1097个中高危),最老的一处潜伏了约40年。普通值友用不到这功能,但侧面证明它啃硬骨头任务的能力是真的——代码审计、安全自查这类场景可以重点关注。🔍
二、Coding Plan四笔账:闲时半价+缓存才是省钱核心
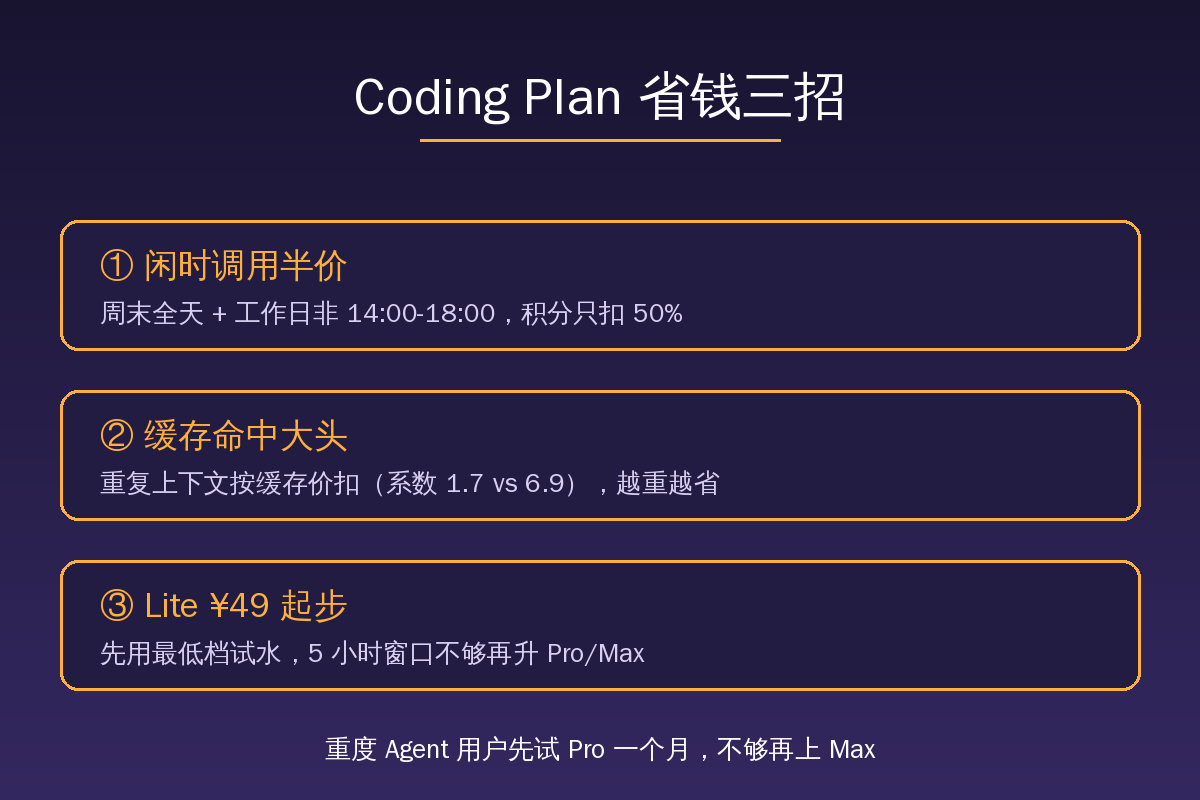
新版GLM Coding Plan换成了积分制,额度公开透明:GLM-5.3输入扣6.9分/百万Token、缓存输入仅扣1.7分、输出扣24分;GLM-5.3-Flash便宜得多(2.3/0.56/8分)。三档套餐:Lite每周1万积分、Pro每周6万、Max每周14万,且都带5小时滑动窗口。
账一:闲时直接半价。工作日14:00-18:00(UTC+8)是高峰,其余时间+周末全天全部按50%积分消耗。周末和晚上写代码的值友,天然享受五折——这招用好了,同样预算多干一倍的活。
账二:缓存命中才是大头。编程Agent反复读同一份代码上下文,缓存命中率官方称可达98%+,而缓存价只有原价的1/4(1.7 vs 6.9)。按官方换算表,Pro套餐在98%缓存命中下一周实际能跑GLM-5.3约3.1~6.3亿Token,Max更是6.9~14.6亿——重度Agent工作流也基本够用。实测建议:尽量在同一个会话里连续干活,别频繁开新窗口,缓存省出来的都是真金白银。
账三:对比竞品订阅。课代表把主流方案拉了张表(2026年10月公开价格):
| 方案 | 价格 | 模型/能力 | 风险点 |
|---|---|---|---|
| GLM Coding Plan | Lite约¥49/月起,Pro约¥149/月 | GLM-5.3开源编程SOTA,1M上下文 | 5小时窗口有积分上限,超高强度党注意 |
| DeepSeek开放平台 | 按量:V4.1-Flash约$0.3/$1.2每百万Token,错峰再砍半 | V4.1-Flash免费版日常够用,Agent能力逼近Pro | 按量付费,重度用户月账单不可控 |
| Kimi API | K3:缓存命中¥2/未命中¥20,输出¥100每百万Token | 2.8T参数开源旗舰,1M上下文,Swarm多智能体 | 输出价高,长任务烧钱快 |
| Claude订阅 | 约$20~200/月 | 编程第一梯队 | 封号潮+国内支付门槛+网络环境 |
账四:接入成本几乎为零。GLM Coding Plan支持ZCode、Claude Code、Codex、OpenCode、WorkBuddy等20+编程工具,Anthropic兼容接口一行配置切过去。以Claude Code为例,把接口地址换成智谱的Anthropic兼容端点、填上API Key,模型写glm-5.3即可;想开真1M上下文就用glm-5.3-flash[1m]并把压缩窗口参数调到100万。对被封号潮折腾怕了的值友,这就是”换个钥匙开门,屋里家具全没动”。🔧
另外注意:GLM-5.3是纯文本模型,GLM-5.3-Flash才是多模态(支持图像理解),需要看图的功能记得切Flash版。
三、什么值友适合上车?课代表对号入座
✅ 日常写代码、偶尔开Agent:Lite档起步试水,闲时+周末半价,一顿饭钱换开源SOTA模型,值。
✅ Claude Code重度用户、被封号潮伤过:直接Pro档,把模型换成GLM-5.3,工作流零改动;官方还给了1M压缩窗口配置教程,长仓库友好。
⚠️ 每天Agent连续跑5小时以上的高强度党:5小时积分窗口是硬限制,跑大型重构前先估算积分消耗;Pro不够别硬撑,上Max档(约¥469/月,闲时半价+缓存命中下实际额度可观),或DeepSeek按量兜底。
❌ 只想要免费聊天的值友:别买订阅,豆包/DeepSeek/Kimi网页版免费额度够用,别为用不上的能力掏钱。
课代表总结
👍 优点:开源编程SOTA名副其实,Terminal-Bench开源断层第一;积分制+闲时半价+98%缓存命中,实际成本比表面价格低一大截;兼容Claude Code生态迁移零成本;权重发布两周后开源(官方已完成安全加固),可自部署;API侧还有98%缓存命中率的官方优化。
👎 缺点:纯文本主力模型不带多模态(要切Flash版);5小时积分窗口对超高强度用户是天花板;与最强闭源模型(Claude Fable 5)仍有可感知差距;开源权重目前仅限Flash系列,旗舰5.3自部署还要等。
一句话:Claude Code封号潮的备胎计划里,GLM-5.3现在是最能打的国产选项之一——先上Lite试一周,闲时半价的快乐,试过就回不去了。值友最近在用什么AI编程工具?GLM和DeepSeek你站哪边?评论区聊聊!👇
📂 更多推荐
- 查看更多相关文章:https://www.88531.cn
- 关注公众号「实用软技」获取更多软件推荐和实用技巧
- 所有软件均提供夸克网盘下载,公众号回复「软件」一键获取
