豆包工作一口气接入Kimi、GLM、DeepSeek!3家大模型怎么选?值友按场景挑不花冤枉点数
目录
值友们好!AI办公圈10月末的大消息:10月29日,豆包工作面向企业客户开放了第三方大模型服务,首批接入三款——Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash。功能默认启用,企业不用再单独找模型厂商买 API 权限,调用费用按实际用量从已有的 AI 点数里扣。
听起来是”全都要”的好事?恰恰相反😅。三款模型能力方向完全不同,全开不如按场景选对:长文档研究、多步骤任务执行、高频批量处理,各有各的位置。今天小软同学就把这三家一次说清,值友们按图索骥,别把点数花在刀背上。
📦 先说清楚:豆包工作是个啥?
豆包工作上线于8月下旬,字节把 TRAE、扣子(Coze) 这些 AI 生产力产品统一收编到这个品牌下,还深度打通了飞书。早期用户最集中的抱怨就是”没办法接第三方大模型”——自家模型再好,写代码、啃长文档时总想换个手感。
两个月后,入口接进了外部模型。这次更新面向团队订阅版和企业订阅版开放(个人订阅版暂未宣布同步),管理侧权限给得很细:管理员可以按成员、部门、群组或全员划定谁能用哪家模型,还能限定生效入口——比如只允许三方模型在工作电脑和飞书工作台生效,个人设备继续用自家模型,效率和数据边界都能兼顾🔐。
🧪 三款模型逐个拆:各自适合什么活?
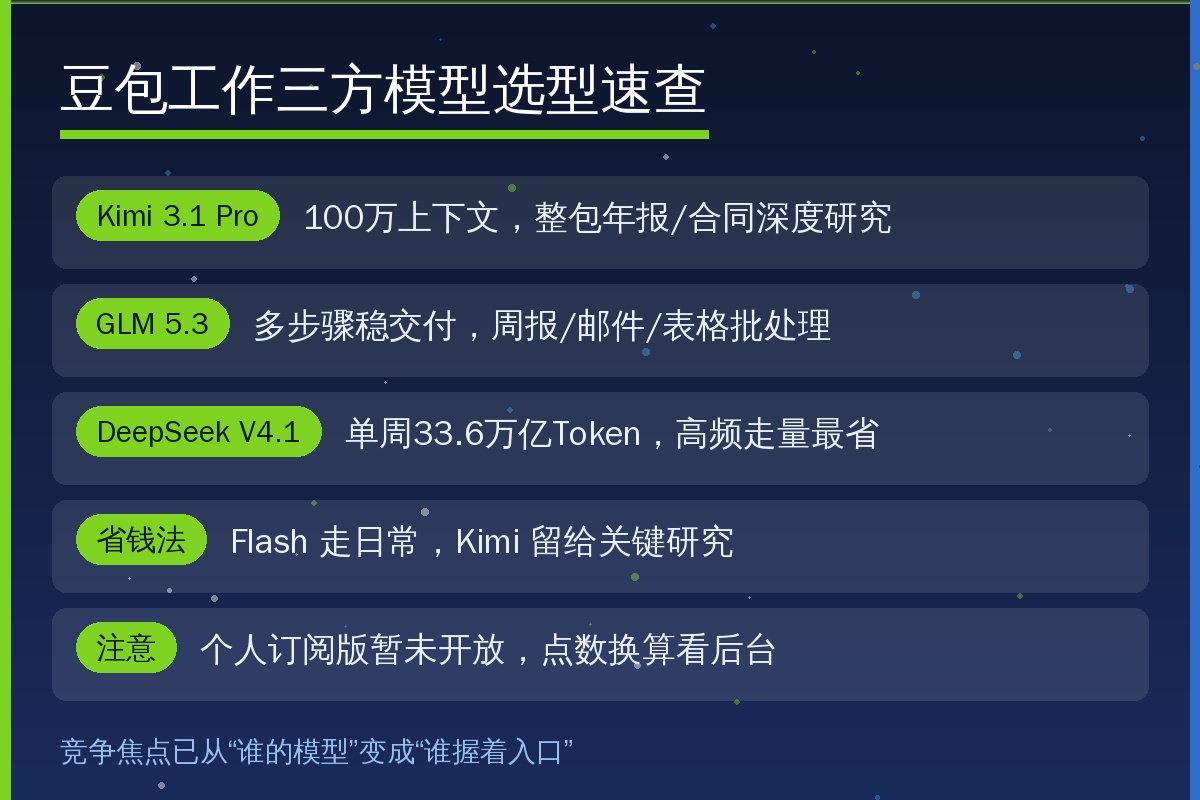
① Kimi 3.1 Pro:一次啃厚资料、做深度研究。月之暗面10月24日发布,官方称是能力最强的3万亿级参数模型,支持 100万上下文,代码、3D创作、金融研究和长程 Agent 能力都是点名提升项。国泰海通研报提到它在独立评测中智能指数居全球第四,长程编码与 Agent 基准多榜登顶。落到办公场景,它适合整本年报、整套合同、多份行业文件的通读与汇总——整包塞进去,不用拆分检索。
⚠️ 成本提醒:这款跑长任务额度消耗不低。月之暗面曾因会员限流和不必要的额度消耗公开致歉,并向全体订阅会员补偿25%月度额度。在企业版里用它做研究类任务前,建议管理员先在点数上留好余量。
② GLM 5.3:多步骤常规任务,执行稳。它是三款里典型的”干活型”模型。在 AI 编程工具 Qoder 里是主力之一,推理强度可按需调档:默认档位从 Max 调到 High 后,单次运行成本降40.5%,约200题的基准测试得分只降6.3%。用户实测反馈也很一致:”踏踏实实干活、干得细致、任务完成有质量,但出方案能力差一些”。适合整理会议材料落文档、按模板批量写通知邮件、把周报数据汇总进表格这类链路清晰的流程📝。
③ DeepSeek V4.1 Flash:高频、大量、日常走量。它是三款里的性价比担当。根据 OpenRouter 数据,10月19日至25日它单周处理33.6万亿 Token,登顶全球调用量周榜第一。速度快、价格低,是它被开发者和工具疯狂接入的直接原因。放到办公场景:会议纪要快速成稿、邮件和工单批量回复、常见问题问答、大批量文本改写,都是它的主场🚀。
📊 场景选型表:值友按这个抄作业
| 办公场景 | 首选模型 | 为什么 | 点数消耗 |
|---|---|---|---|
| 整包年报/合同/行业资料精读 | Kimi 3.1 Pro | 100万上下文,整包塞入不拆分 | 高 |
| 研究报告、跨材料找论据 | Kimi 3.1 Pro | 长程 Agent 与研究能力多榜登顶 | 高 |
| 周报汇总、批量邮件、模板化文档 | GLM 5.3 | 执行稳、细节到位,调档后成本-40.5% | 中 |
| 会议纪要、工单回复、FAQ、批量改写 | DeepSeek V4.1 Flash | 全球调用量第一,快且便宜 | 低 |
| 创意提案、方案脑暴 | 自家模型/Kimi | GLM 出方案能力偏弱,扬长避短 | 中高 |
🟢 小软同学的省钱配置:用 DeepSeek V4.1 Flash 承接大多数日常走量任务,把 Kimi 3.1 Pro 留给关键研究,GLM 5.3 负责链路清晰的批量流程。三档搭配用下来,点数消耗能压到”全开 Kimi”的零头。
🧪 举个例子:一场周会材料,三家怎么分工
假设你是运营负责人,周一要交一份”竞品动态 + 上周数据 + 本周计划”的材料,点数预算有限。合理的分法是这样👇:
DeepSeek V4.1 Flash 先跑量:把上周几十条工单、评论、会议录音转写一股脑丢给它,快速生成”用户反馈分类清单”和”数据异动初筛”——这类任务量大、难度低,正是 Flash 的主场,几秒钟一批,点数几乎不心疼。
Kimi 3.1 Pro 做深研:把三份竞品年报 PDF、两份行业报告整包塞进去,让它输出”竞品本季度战略变化 + 引用出处”——百万级上下文的优势在这里才值回票价,换成要拆分检索的模型,来回试错烧的点数更多📚。
GLM 5.3 收尾落地:拿着前两步的结果,按公司模板把周报写成固定格式、把计划拆成带负责人和时间的表格项,再批量生成三封跟进邮件——要的是稳定交付,不是天马行空,GLM 干这种活最踏实✍️。
一套流程下来,”全用 Kimi”的点数大概只够走完第一步。这就是按场景选模型和无脑全开的差距——不是模型好坏问题,是把对的模型放在对的位置上。
💡 比选模型更重要的两件事
第一,看清楚谁能用。目前是团队版和企业版的权益,个人订阅版还没同步;点数换算率官方也未公布,实际成本得去后台用量里确认。值友如果是小团队决策人,先让管理员把三家的点数消耗跑一周再定规矩📊。
第二,管好生效入口。按部门/群组限模型、限设备入口,这颗粒度才是企业真正该盯的东西——毕竟各家模型的强弱会变(GLM 5.3 半年前还不是主力),入口和权限体系才是长期资产。
⚠️ 新手最容易踩的三个坑
坑一:默认全开就不管了。功能上线即默认启用,意味着成员每一次提问都可能在走点数。管理员最好先按部门灰度一周,看后台用量再放开,否则月底看到账单容易血压飙升💀。
坑二:把研究模型当聊天工具。Kimi 3.1 Pro 跑长任务的点数消耗,和它聊两句日常闲问完全是两个量级。日常问答、改个措辞这种小事,丢给 Flash 就够了,别拿重炮打蚊子。
坑三:只看模型榜单,不看自家任务。榜单第一不等于你的活干得最好——翻译、格式化表格、代码补全这类任务,模型之间的差距远比评测分数小,真正影响体验的是响应速度、点数单价和工作流打通程度。这三点恰恰是”入口”能决定的。
🚀 趋势判断:AI办公的竞争,换赛道了
回头看,这次开放补的正是豆包工作最大的短板。而它背后是个更大的转向:AI办公产品的竞争重心,正从”谁的模型”转向”谁握着调模型的入口”。字节把 TRAE、扣子收编进豆包工作,再开放三方模型,逻辑很清晰——模型可以换,入口和组织权限换不了。
对值友的启发也一样:别再纠结”哪家大模型天下第一”了🙂。2026年下半年的正确姿势,是手里攒一套组合拳——按任务挑模型,按模型配入口,按入口控成本。
✅ 优缺点总结 + 小软同学推荐
👍 优点:一个入口用齐三家用得最顺手的模型,不用分别采购 API;管理权限精细到部门和设备;DeepSeek Flash 这种”全球调用量第一”的走量型模型接入,日常成本立减。
👎 缺点:个人订阅版暂时无缘;点数换算率不透明,成本要自己在后台摸;Kimi 3.1 Pro 跑长任务烧点数,不限额容易月底爆仓。
一句话推荐:如果你所在的团队已经在用豆包工作 + 飞书,这次开放直接开——按”Kimi 研究、GLM 干活、DeepSeek 走量”三档配置,是目前性价比最高的用法。个人用户也别急,入口之争既然开始了,个人版跟进只是时间问题😉。
📂 更多推荐
- 查看更多相关文章:https://www.88531.cn
- 关注公众号「实用软技」获取更多软件推荐和实用技巧
- 所有软件均提供夸克网盘下载,公众号回复「软件」一键获取
