Scrapling 新手使用教程:85.9k Star 的反爬虫框架,pip 一键安装,绕过 Cloudflare 还能自适应网站改版
目录
写爬虫最怕什么?
前一晚还好好的脚本,第二天早上起来全趴窝——页面改版了,选择器失效了;或者更惨的,请求发出去直接被 Cloudflare 拦下,返回一坨”请验证您是真人”的验证码,人当场裂开。
最近 GitHub 上有个项目把这两个痛点一次解决了:Scrapling,目前狂揽 85.9k Star、8.8k Fork,今天还挂在 GitHub Trending 日榜上(单日 +858 Star)。它是一套自适应的 Python 爬虫框架,官方一句话介绍就很嚣张:
从单次请求到整站爬取,一个框架全搞定;解析器能”记住”元素,网站改版后自动帮你把数据找回来;抓取器开箱绕过 Cloudflare Turnstile。
今天这篇新手教程,从零开始带你装上、跑通、爬到数据,全程照抄就能运行。
一、Scrapling 是什么来头?
先看仓库真实数据(截至发文时):
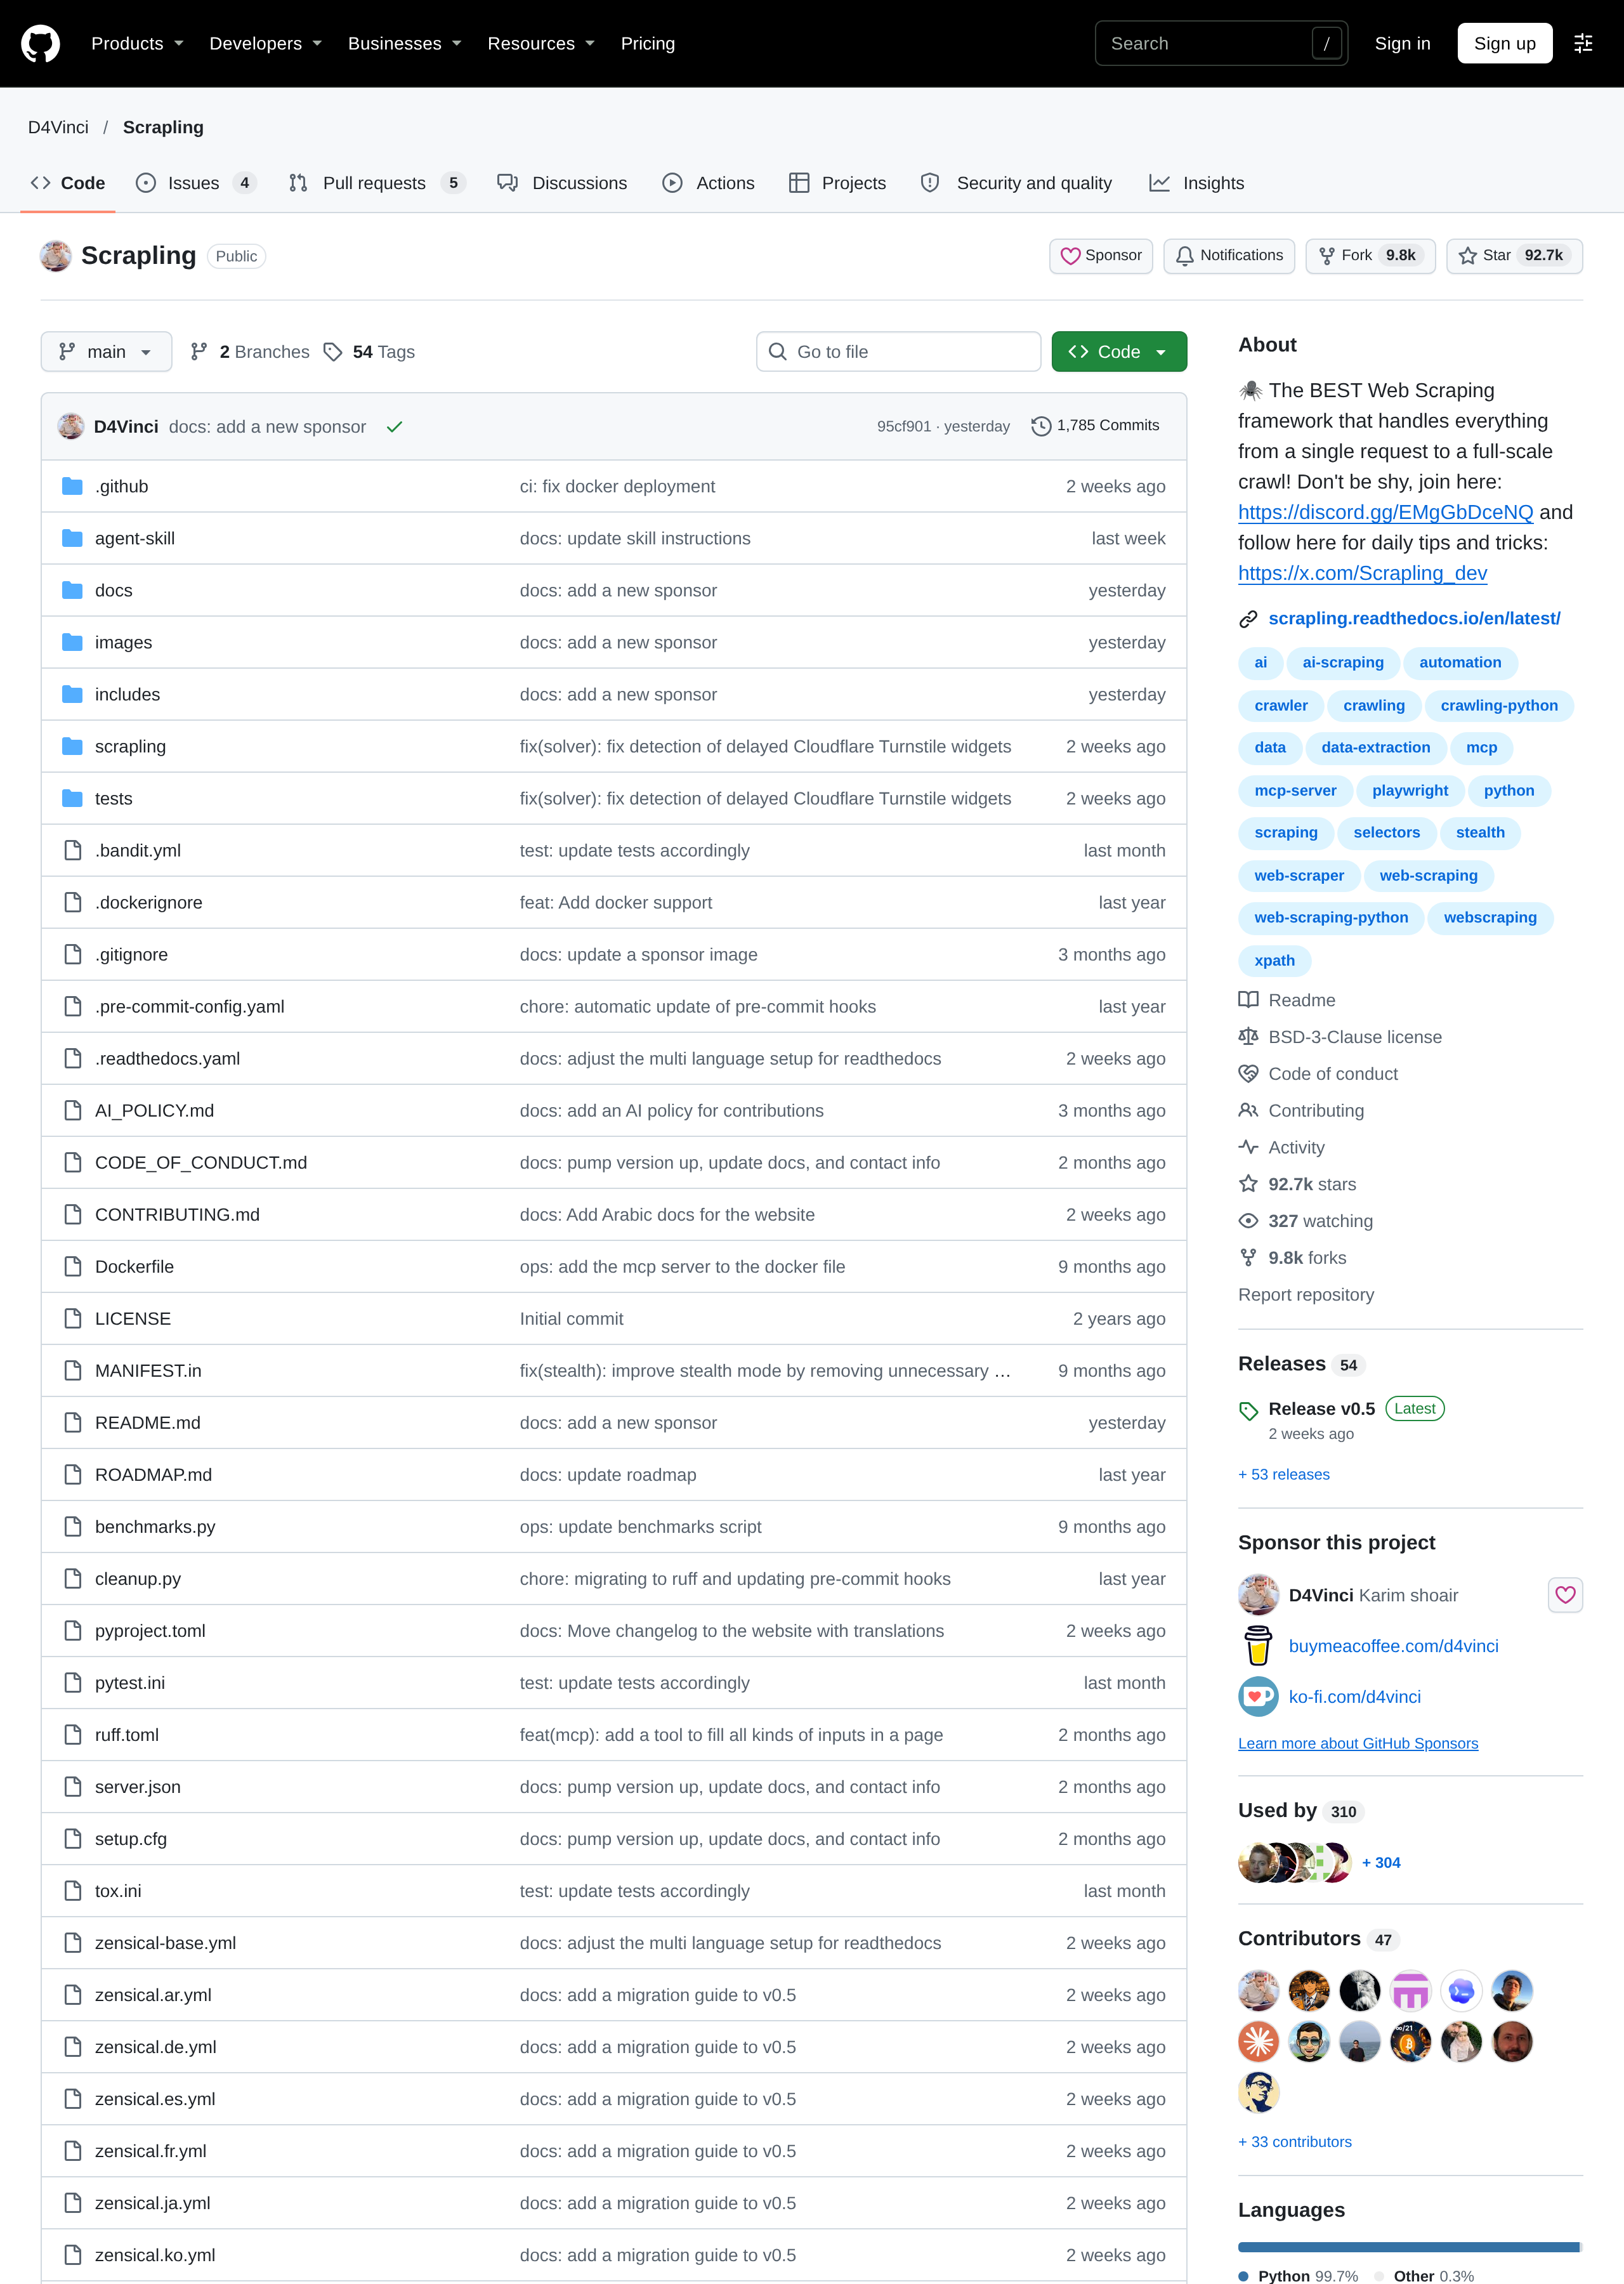
| 项目 | 数据 |
| 仓库 | D4Vinci/Scrapling |
| Star / Fork | 85.9k / 8.8k |
| 开源协议 | BSD-3-Clause(可放心商用、改造) |
| 最新版本 | v0.5(2026-10-17 发布) |
| 语言支持 | Python 3(文档已翻译成中日韩等 10 种语言) |
| 测试覆盖率 | 92%,全量类型标注 |
它和你可能用过的 BeautifulSoup、Scrapy 什么关系?API 长得像 Scrapy/BeautifulSoup(选择器语法一模一样),但内核完全不同,主打三件事:
- 自适应解析:选择器记住了元素,网站改版后传个参数就能自动重新定位;
- 反爬绕过:内置隐身抓取器,能过 Cloudflare Turnstile 这类”真人验证”;
- 整站爬取框架:并发爬取、断点续爬(Ctrl+C 停下,重启接着爬)、自动代理轮换、自动调节请求速度。
换句话说:以前要拼三四个库才能干的事,现在一个 pip 包全包了。
二、安装:两行命令搞定
打开终端(命令行),先确保有 Python 3.9+,然后:
pip install scrapling
装完再执行一次初始化命令,它会自动把浏览器内核等额外依赖装好(爬动态页面要用):
scrapling setup
小提示:国内网络 pip 慢的话,加个清华镜像:
pip install scrapling -i https://pypi.tuna.tsinghua.edu.cn/simple。另外官方还提供 Docker 镜像(docker pull pyd4vinci/scrapling),不想折腾环境可以直接拉。
三、第一个爬虫:5 分钟爬到数据
新建一个 demo.py,粘贴下面这段(这是官方示例站,专供练手,随便爬):
from scrapling.fetchers import Fetcher

page = Fetcher.get('https://quotes.toscrape.com/')
quotes = page.css('.quote .text::text').getall()

for q in quotes:
    print(q)
运行:
python demo.py
控制台会刷出一堆名人名言——爬取成功。拆解一下这几行:
Fetcher.get(...)—— 发一个 HTTP 请求拿回页面,相当于 requests,但默认伪装成 Chrome 浏览器的 TLS 指纹(网站很难认出你是脚本);page.css('.quote .text::text')—— CSS 选择器取元素,语法和 BeautifulSoup/Scrapy 完全一样,会的人零学习成本;.getall()—— 一次拿全部,只取第一条用.get()。
想取正文以外的东西?XPath 也支持:
titles = page.xpath('//span[@class="text"]/text()').getall()
四、进阶一:遇到反爬网站怎么办?
普通请求被拦(比如目标站套了 Cloudflare),换 StealthyFetcher——它会启动一个”隐身浏览器”,模拟真实浏览器行为并自动过验证:
from scrapling.fetchers import StealthyFetcher

page = StealthyFetcher.fetch(
    'https://example.com/',
    headless=True,          # 无界面模式,服务器上也能跑
    solve_cloudflare=True,  # 自动过 Cloudflare 验证
)
data = page.css('.product').getall()
还有一种 DynamicFetcher,就是完整的浏览器自动化(基于 Playwright),适合页面靠 JavaScript 动态加载的情况。
三个抓取器怎么选?一张表说清楚:
| 抓取器 | 底层 | 适用场景 |
| Fetcher | HTTP 直连 | 静态页面,速度最快 |
| StealthyFetcher | 隐身浏览器 | 有反爬/验证码的站 |
| DynamicFetcher | Playwright 浏览器 | JS 动态渲染的页面 |
它们都有对应的 Session 版本(FetcherSession、StealthySession、DynamicSession),用 with 包起来就能跨请求保持 Cookie 和登录状态——登录一次,后面随便爬。
五、进阶二:网站改版了,脚本不用重写
这是 Scrapling 最”黑科技”的地方:自适应选择器。
普通爬虫一旦页面结构调整,选择器就废了。Scrapling 的做法是——第一次抓取时把元素”记住”,之后网站怎么改版,它都能靠相似度算法自动把原来那个元素找回来:
# 第一次抓取时开启自适应
products = page.css('.product', auto_save=True)

# ...过阵子网站改版了,选择器对不上了?
# 传 adaptive=True,它会自动重新定位原来的元素
products = page.css('.product', adaptive=True)
对需要长期跑的采集任务来说,这功能等于给脚本上了份”防改版保险”。
六、进阶三:整站爬取(Spider 框架)
要爬整个网站,就用它的 Spider 框架,写法和 Scrapy 几乎一样:
from scrapling.spiders import Spider, Response

class MySpider(Spider):
    name = "demo"
    start_urls = ["https://example.com/"]

    async def parse(self, response: Response):
        for item in response.css('.product'):
            yield {"title": item.css('h2::text').get()}

MySpider().start()
别小看这几行,背后自带一整套工程能力:
- 并发爬取 + 按域名限速,爬太快被封会自动降速(AutoThrottle);
- 断点续爬:Ctrl+C 优雅退出,重新运行自动从断点接着爬;
- 阻塞检测:请求被拦自动识别并重试;
- 内置导出:
result.items.to_json()/to_csv()一行出数据; - 还有现成模板:
CrawlSpider(按规则跟进链接)、SitemapSpider(按 sitemap 爬)、ShopifySpider(一键爬完 Shopify 商城所有商品)。
七、彩蛋:不想写代码也能爬
Scrapling 自带命令行,直接在终端里爬一个 URL:
scrapling extract "https://example.com" --css ".product"
另外它还内置了一个交互式 IPython 壳(scrapling shell),可以边调试边写脚本,甚至把浏览器开发者工具里的 curl 请求直接转成 Scrapling 代码。
对 AI 时代来说更实用的是:它自带 MCP Server,接进 Claude、Cursor 这类 AI 工具后,AI 能直接帮你爬网页、过验证码、提取数据,还能一键把网页转成干净的 Markdown 喂给大模型做知识库。
八、官方文档(有中文)
官方文档已经翻译成简体中文,装之前或用的时候都可以翻一翻:
地址:https://scrapling.readthedocs.io(右上角可切中文)
九、常见问题 FAQ
Q:和 Scrapy 比哪个好?
A:新手建议先玩 Scrapling——API 差不多但更现代,反爬和自适应是送的;已有 Scrapy 项目也能无缝接入(加个 @scrapling_response 装饰器就能用 Scrapling 的解析器)。
Q:爬虫违法吗?
A:框架本身仅供学习研究,实际使用请遵守目标网站的服务条款和 robots.txt,别拿去爬个人隐私数据。
Q:Windows 上能用吗?
A:能,Python 3.9+ 全平台支持;v0.5 还专门修了 Windows 管理员权限下启动浏览器的 bug。
写在最后
说实话,现在爬虫库卷成这样,Scrapling 还能单日涨 858 Star 不是没道理的——它把”反爬绕过”和”改版自适应”这两个最烦人的痛点做成了开箱即用,同时保留了 Scrapy 老用户熟悉的写法。如果你正被某个网站的反爬折磨,或者受够了改一次版就要改一次脚本,真的可以试试它。
📥 资源下载
官方 GitHub 源码仓库(v0.5):
https://github.com/D4Vinci/Scrapling
源码包直链(v0.5 zip,约 4.3MB):
https://codeload.github.com/D4Vinci/Scrapling/zip/refs/tags/v0.5
PyPI 安装(推荐):
https://pypi.org/project/scrapling/
注:本机夸克网盘登录凭证已过期(需扫码重新登录后才能转存),本次下载区改用官方 GitHub 源,可正常下载。
关注公众号:「实用软技」,在公众号窗口里回复关键字“软件”即可免费获取
