扫描的PDF看不了字?批量转双层PDF v4.2,OCR识别多国语言
你有没有这种体验:单位发来的合同、网上下载的扫描版电子书,全是图片——想搜个关键词,搜不了;想复制一句话,复制不了;翻页还慢得要死。看得见,就是”摸不着”。
解决办法就一个:把它变成双层PDF——上面是原文图像(长得跟原来一模一样),下面藏了一层可搜索、可复制的文字层。批量转双层PDF v4.2 就是专门干这事的。
批量处理:一堆扫描件 PDF 直接全选丢进去,一键跑完整个文件夹,不用一个个点。
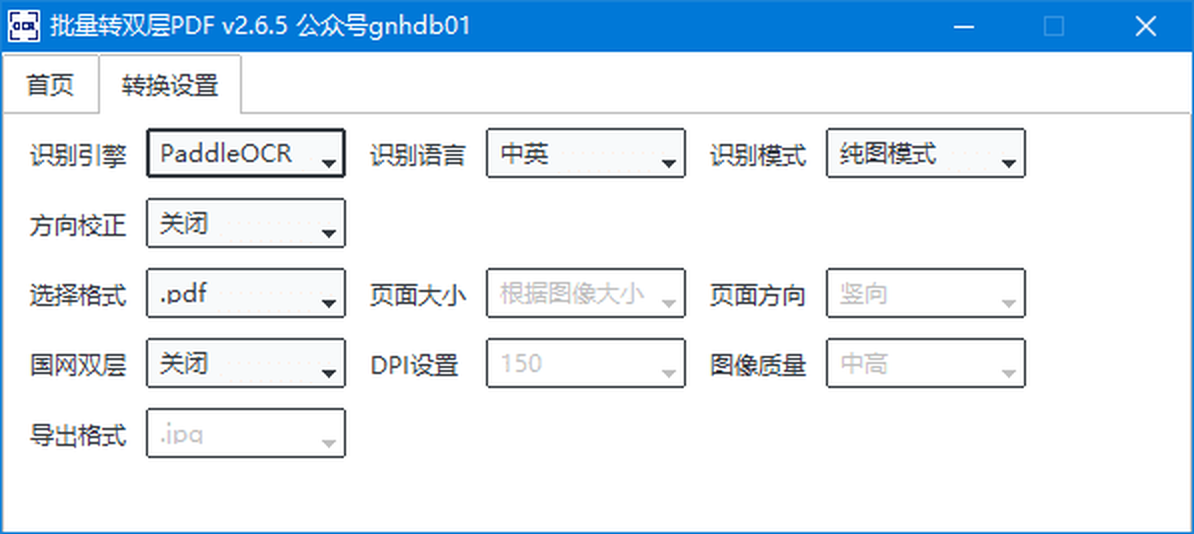
自动校正歪斜:扫描时纸张放歪了、倒了,它自己转回来再识别,识别率不受影响。
多国语言 OCR:中英文混排、日文、德文……识别语种可以自己选,精度档位也能调,要快还是要准随你。
自动删空白页:扫描件里那些纯空白的废页,直接帮你剔掉,文件体积小一圈。
递归读子目录:文件夹套文件夹的资料,勾一个选项全收进来,整套档案一次转完。
全程本地离线:这点对处理合同、档案的兄弟特别重要——文件不出你电脑,隐私不外泄。
📋 更新日志
- v4.2(2026-11-04):支持 v6 模型的版本已并入主版本;更新 OFD 模块,转换更稳定;新增 JPEG 格式转双层 PDF;新增 Python API 接口和命令行调用方式——可以指挥 AI 工具帮你批量转,或者自己写脚本调用,说明文档附在安装包里。
- 遇到用不上的功能,直接问 AI 就行,文档写得很全。
小提醒:绿色版解压即用。第一次跑建议先拿两三个文件试水,看看识别精度档位哪个合适,再批量上量。输出目录记得单独设一个,别跟原文件混一起。
搞档案的、写论文的、经常收扫描件的,这个软件能省你半天功夫。
📥 软件下载
夸克网盘下载:https://pan.quark.cn/s/310aae9dc436
(内含本篇软件,打开对应文件夹即可)
关注公众号:「实用软技」,在公众号窗口里回复关键字”软件”即可免费获取
