手把手教你用 Scrapling:Python 爬虫新王,从安装到绕过 Cloudflare 实战(2026-11-11)
目录
手把手教你用 Scrapling:Python 爬虫新王,从安装到绕过 Cloudflare 实战(2026-11-11)
一、写在前面:你是不是也被爬虫折磨过?
说到爬虫,你是不是也经历过这些崩溃瞬间:
- 用
requests抓页面,结果被 Cloudflare 一巴掌拍回来,代码里全是403 Forbidden; - 用
BeautifulSoup4解析,页面一改版,选择器全失效,又得一行行重写; - 想并发抓快一点,代理、重试、断点续传全要自己拼,光搭框架就搭了三天。
好家伙,抓个数据比写业务还累。别急,今天这篇文章就带你从零上手 Scrapling —— 本周 GitHub 狂飙到 10 万星 的 Python 爆款爬虫框架。跟着走完,你就能自己写出一个能绕过反爬、能并发、还能断点续传的爬虫。
二、Scrapling 到底是什么?
一句话:一个把”发请求、开浏览器、解析页面、并发爬取”打包在一起的 Python 库。
“框架”这个词听着高大上,其实意思就是:以前你要装 5 个库、写一堆胶水代码才能干成的事,现在一个 scrapling 全包了。它有几个杀手锏(都是大白话解释):
- 三种抓取模式:普通 HTTP 请求(快)、隐身浏览器(能过反爬)、纯解析(不联网也能用);
- 自带过验证码能力:官方说能处理 Cloudflare 的 Turnstile 和拦截页——就是那种”正在验证您是否是人类”的烦人弹窗;
- 自适应元素追踪:页面改版后元素挪了位置,它能自己”认出”原来那个元素,不用你重写选择器;
- 内置爬虫模式:并发请求、代理轮换、自动重试、暂停/断点续传、导出 JSON/CSV,全是现成的;
- 对 AI 友好:内置 MCP Server,Claude、Cursor 这类 AI 工具可以直接驱动它爬网页。
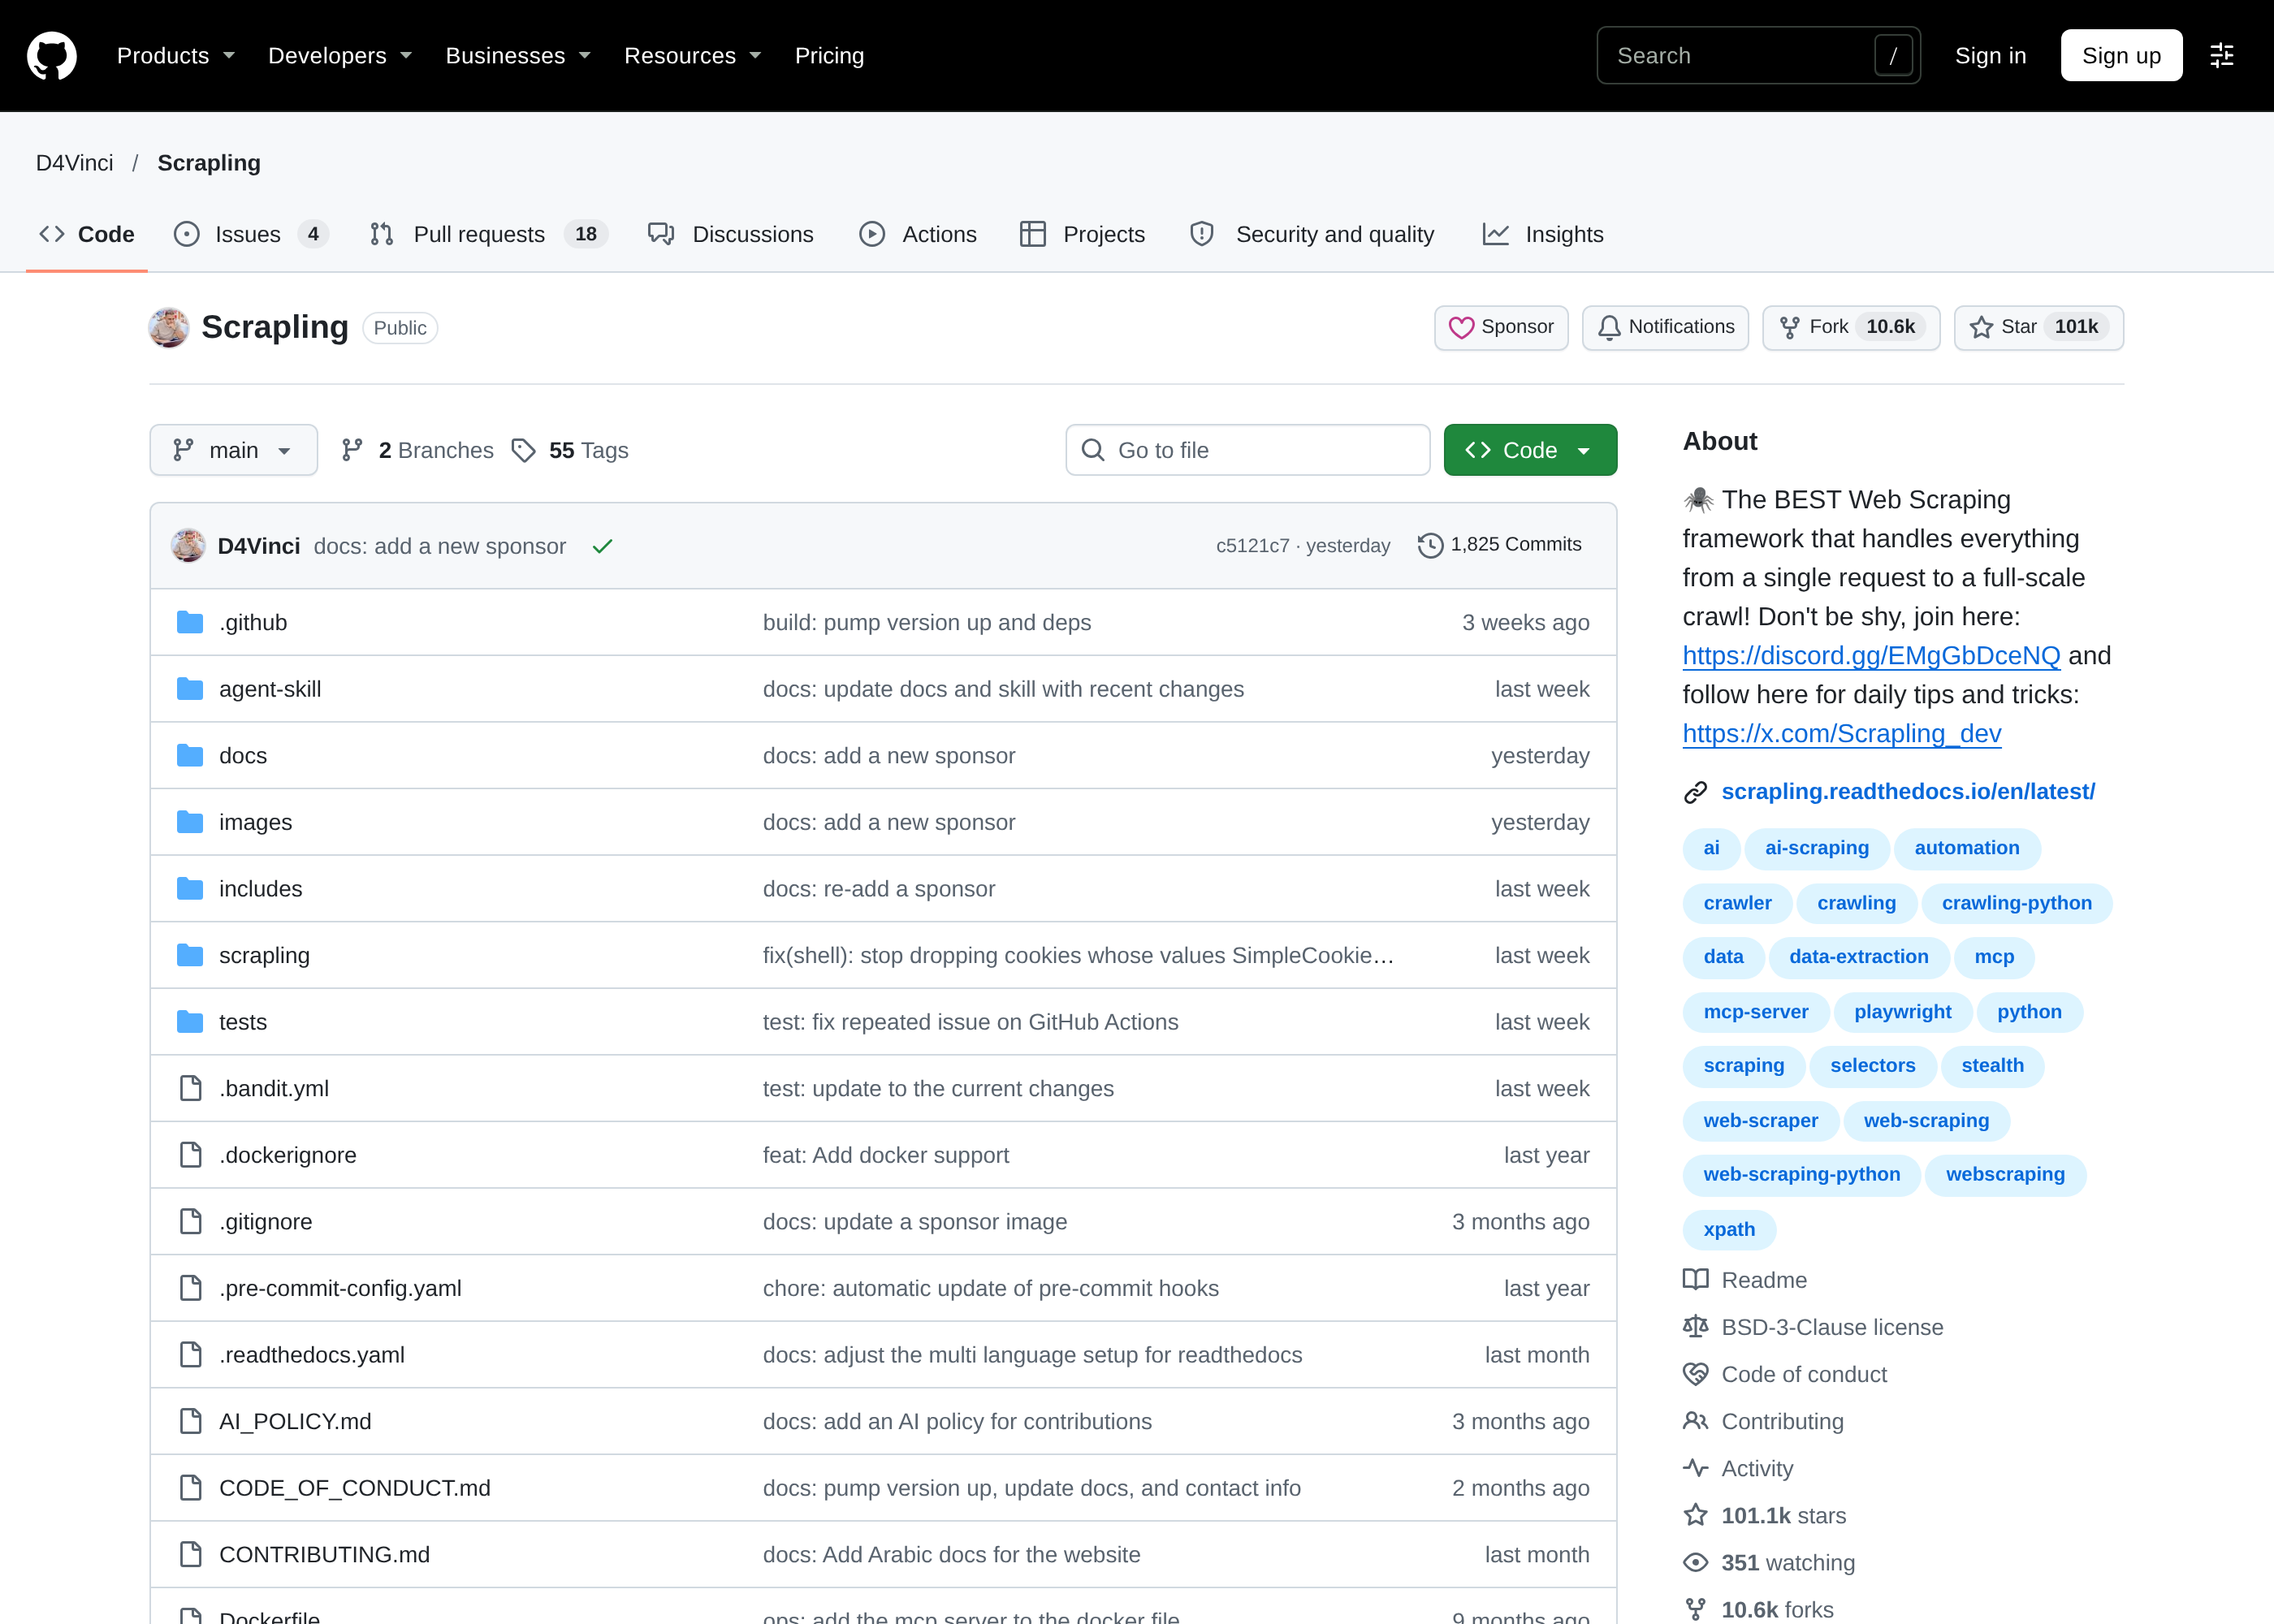
项目地址(开源免费,BSD 协议):https://github.com/D4Vinci/Scrapling
三、安装:两条命令搞定
环境要求:Python 3.10 及以上(命令行敲 python --version 确认一下)。
第 1 步,打开终端(Windows 用 CMD 或 PowerShell,Mac/Linux 用终端),敲:
pip install "scrapling[fetchers]"
注意引号别丢。[fetchers] 的意思是”连抓取器一起装”——只装基础包的话,Fetcher、爬虫这些功能会报 ModuleNotFoundError,所以新手直接带中括号装就对了。
第 2 步,安装浏览器依赖(隐身浏览器要用,爬动态页面必备):
scrapling install
装完验证一下:
python -c "import scrapling; print(scrapling.__version__)"
能打印出版本号(当前最新 v0.5.1)就说明成功了。
如果你网络不好 pip 老超时,可以换国内镜像:
pip install "scrapling[fetchers]" -i https://pypi.tuna.tsinghua.edu.cn/simple
四、第一个爬虫:5 行代码抓名言
官方示例网站 quotes.toscrape.com 是专门给爬虫练习用的,放心抓。
新建文件 demo.py,粘贴下面的代码:
from scrapling.fetchers import Fetcher

page = Fetcher.get('https://quotes.toscrape.com/')

for quote in page.css('.quote')[:3]:
    text = quote.css('.text::text').get()
    author = quote.css('.author::text').get()
    print(author, '->', text)
运行 python demo.py,控制台就会输出 3 条名言和作者。
逐行解释一下新手最容易懵的点:
Fetcher.get(...)—— 相当于 requests 的get,发一个 HTTP 请求把页面抓回来;page.css('.quote')—— 用 CSS 选择器挑出所有名言块,跟 BeautifulSoup 的find_all一个思路;::text—— 这是 Scrapling 的小魔法,意思是”我要标签里的文字”,不用再写.get_text();.get()—— 只拿第一个结果,.get_all()拿全部。
想抓下一页?元素自带导航方法:
first_quote = page.css('.quote')[0]
next_link = page.css('.next a')[0]
print(next_link.attrib['href'])   # 下一页地址
五、进阶一:动态页面 & 绕过反爬
上面抓的是静态页面。遇到 JavaScript 渲染的页面(内容是页面加载后才生成的),换成浏览器模式:
from scrapling.fetchers import Fetcher

# fetcher=True 会启动真实浏览器渲染页面
page = Fetcher.get('https://example.com', fetcher=True)
print(page.css('h1')[0].text)
被 Cloudflare 拦了怎么办?加隐身参数:
page = Fetcher.get(
    'https://target-site.com',
    fetcher=True,
    headless=True,        # 无头模式:不开窗口,更快
    solve_cloudflare=True # 尝试自动处理 Cloudflare 验证
)
小提醒(认真脸):绕反爬功能仅供学习研究用,实际项目请遵守目标网站的 robots.txt 和当地法律,别拿去干坏事。
六、进阶二:一键爬全站的 Spider
要爬几百上千页,用它的 Spider 模式——你只管写”怎么解析”,并发、翻页、重试它全帮你搞定:
from scrapling.spiders import Spider, Response

class QuotesSpider(Spider):
    name = "quotes"
    start_urls = ["https://quotes.toscrape.com/"]
    concurrent_requests = 10   # 同时发 10 个请求

    async def parse(self, response: Response):
        for quote in response.css('.quote'):
            yield {
                "text": quote.css('.text::text').get(),
                "author": quote.css('.author::text').get(),
            }
        next_page = response.css('.next a')
        if next_page:
            yield response.follow(next_page[0].attrib['href'])

result = QuotesSpider().start()
print(f"共抓到 {len(result.items)} 条")
result.items.to_json("quotes.json")   # 直接存成 JSON
注意 async def parse 的 async 不能少,这是异步写法(理解成”同时干多件事”就行)。跑完目录下会多一个 quotes.json,数据直接可用。
七、常见问题 FAQ
Q1:装完 import 报 ModuleNotFoundError?
A:八成是只装了 pip install scrapling,没带 [fetchers],重装一下就好。
Q2:启动浏览器报找不到浏览器?
A:先跑 scrapling install,它会自动下载 Playwright 需要的 Chromium。
Q3:和 Scrapy、BeautifulSoup 是什么关系?
A:BS4 是纯解析库(只管解析不管抓),Scrapy 是重型爬虫框架(配置多、上手慢)。Scrapling 居中:既能当解析库用,也能当轻量爬虫框架用,还兼容 Scrapy——官方给了个 @scrapling_response 装饰器,你现有的 Scrapy 项目可以直接借用它的解析器。
Q4:能中文输出吗?
A:数据抓下来就是字符串,存 CSV/JSON 时记得加 encoding='utf-8-sig',Excel 打开不乱码。
八、软件下载
Scrapling 是开源免费软件(BSD-3-Clause 协议),直接从 GitHub 官方仓库下载(v0.5.1 源码包):
https://github.com/D4Vinci/Scrapling/archive/refs/tags/v0.5.1.zip
也可以直接 pip 安装(推荐):
pip install "scrapling[fetchers]"
项目主页:https://github.com/D4Vinci/Scrapling
官方文档:https://scrapling.readthedocs.io/
九、写在最后
说实话,现在爬虫库卷成这样,Scrapling 还能一周狂揽几万星不是没道理的——解析快(官方测试比 BS4 快几百倍)、能过反爬、还顺手把 AI 接口做好了,属于是把新手的坑一个个填平了。如果你正被 requests + bs4 的各种报错折磨,不妨花十分钟装个 Scrapling 试试,真香。
关注公众号:「实用软技」,在公众号窗口里回复关键字”软件”即可免费获取
